AI / Agent
PyBot, MIRAS, Weight-Space Programming
코드는 파라미터처럼 최적화되고 가중치는 코드처럼 고쳐진다. 그 사이에서 남는 프로그래밍
Hugging Face가 2026년 11월 공개한 PyBot[1]은 신경망 가중치가 하나도 없는 챗봇이다. if-else 분기, 정규표현식, 조회 테이블만으로 대화한다. 사람이 쓴 것도 아니다. README에 따르면 1,000개가 넘는 코딩 에이전트가 5,000개 넘는 버전을 쓰고 평가했으며, LLM 심판이 참조 답과 비교하는 벤치마크 SmolTalkBench에서 승률이 0%에서 26%로 올랐다. 몇 년 전 1B 미만 모델 중 최고 수준이던 SmolLM-360M-Instruct와 비슷한 점수다. 결과물은 Python 약 64만 줄이다.
나는 앞서 환경으로서의 하네스에서 기능 코드를 정밀하게 세공해 납품하는 시대가 저물고, 중요한 것은 환경·데이터·평가 기준이라고 썼다. 여기서 한 걸음 더 나가면 소프트웨어 공학의 통념과 부딪히는 주장이 된다. 구조와 추상화는 단단히 지키되, 그 안의 일부는 정규표현식을 떡칠해서라도 현장에서 가볍게 적응할 수 있도록 열어 둘 수 있다. 처음부터 끝까지 애드혹으로 짜자는 말이 아니다. 잘 변해야 하는 부분과 변하면 안 되는 부분을 나누고, 앞의 것에는 코드 품질의 통념을 적용하지 않아도 된다는 말이다. PyBot은 이 주장을 시험하기 좋은 표본이다. 64만 줄의 지저분함은 120줄짜리 고정 계약 위에서만 허용됐다. 열어 둔 부분과 닫아 둔 부분이 처음부터 나뉘어 있었고, 그 나눔이 이 실험을 가능하게 했다.
같은 달, 정반대 방향의 실험도 나왔다. MIT CSAIL의 Takehi, Teoh, Zhang, Khattab은 Sparks of Weight-Space Programming[2](2026-11-02)에서 GPT-6 Astra가 신경망 가중치를 코드처럼 읽고 고칠 수 있음을 보였다. 경사하강법 없이 Qwen3.5-0.8B 가중치의 0.016%를 고쳐 MATH-500을 7.9%에서 48.1%로 올렸다. PyBot은 코드를 가중치처럼 최적화했고, 이 실험은 가중치를 코드처럼 프로그래밍했다. 그 사이에 Behrouz 등의 MIRAS가 있다. 기억을 실행 중에 학습되는 파라미터로 보고, 무엇을 얼마나 빨리 바꾸고 얼마나 붙잡아 둘지를 설계 변수로 다룬다.
세 사례를 함께 놓으면 프로그래밍이 무엇인지가 달라진다. 프로그램의 표현이 코드인지 가중치인지는 더 이상 중요한 구분이 아니다. 둘 다 LLM이 읽고 쓰는 대상이 되었다. 남는 설계 문제는 셋이다. 어느 부분을 고정하고 어느 부분을 열어 둘지, 열어 둔 부분이 얼마나 빨리 바뀌게 할지, 무엇으로 변화를 평가해 채택할지. 이 글은 PyBot을 자세히 해부해 이 세 질문이 실제 시스템에서 어떻게 구현되었는지 보이고, Weight-Space Programming과 MIRAS로 같은 구조를 확인한다.
아래 관측은 2026-11-19에 저장소 커밋 7d63c7f(봇 코드는 스웜 저장소 커밋 24cbc04의 사본)를 macOS의 Python 3.15.2로 실행해 얻었다.
저장소 해부: 한 턴은 어떻게 처리되는가
PyBot의 몸통은 bot/ 아래 528개 파일이다. README는 이를 네 공유 부품과 응답 모듈로 나눈다. 줄 수를 직접 세면 다음과 같다.
[!TABLE] 표 1.
bot/하위 디렉터리별 크기(wc -l실측)
| 부품 | 경로 | 역할 | 줄 수 |
|---|---|---|---|
| 이해 엔진 | bot/understanding/ | 오타·채팅체 해석, 주제, "it"이 가리키는 대상 | 25,026 |
| 기억 저장소 | bot/memory/ | 지금까지 사용자와 봇이 한 말 | 109,319 |
| 지식 베이스 | bot/knowledge/ | 세상에 대한 사실을 데이터로 보관 | 316,852 |
| 응답 작성기 | bot/compose/ | 답의 문장, 맞는 답이 없을 때 할 말 | 104,286 |
| 응답 모듈 | bot/modules/ | 매 턴 답을 제안하는 110개 모듈과 중재기 | 80,926 |
절반이 지식 베이스다. 요리(cooking.py 12,887줄), 여행, 반려동물, 건강, 돈 같은 생활 주제가 파일 하나씩을 차지한다. 이 벤치마크가 일상 대화를 묻기 때문인데, 이 점은 뒤에서 다시 본다.
흥미로운 파일은 가장 작은 쪽에 있다. bot/runtime.py는 120줄이고 첫 줄이 이렇다.
"""Fixed module interface. Edit bot/modules/, never this file.
이 파일이 한 턴의 절차를 고정한다. 모든 모듈을 PRIORITY 내림차순으로 불러 세 단계를 돌린다.
observe(text, memory): 이름, 사실, 주제를 기억한다. 답하지 않는다.respond(text, memory): 답 문자열을 제안하거나None으로 넘긴다. 각 모듈은 기억의 사본에서 일하므로 채택되지 않은 제안은 흔적을 남기지 않는다.choose(text, memory, candidates):bot/modules/arbiter.py의 중재기가 후보 하나를 고르고, 채택된 모듈의 기억 사본이 대화의 기억이 된다.
그 뒤 after()가 돌고 런타임이 턴 기록을 덧붙인다. 실패 처리도 이 파일이 정한다. import에 실패한 모듈은 목록에서 빠지고, 중재기가 예외를 던지거나 엉뚱한 값을 돌려주면 우선순위가 가장 높은 첫 후보가 채택된다. 주석은 "A module that fails is skipped; a turn never fails."라고 적는다.
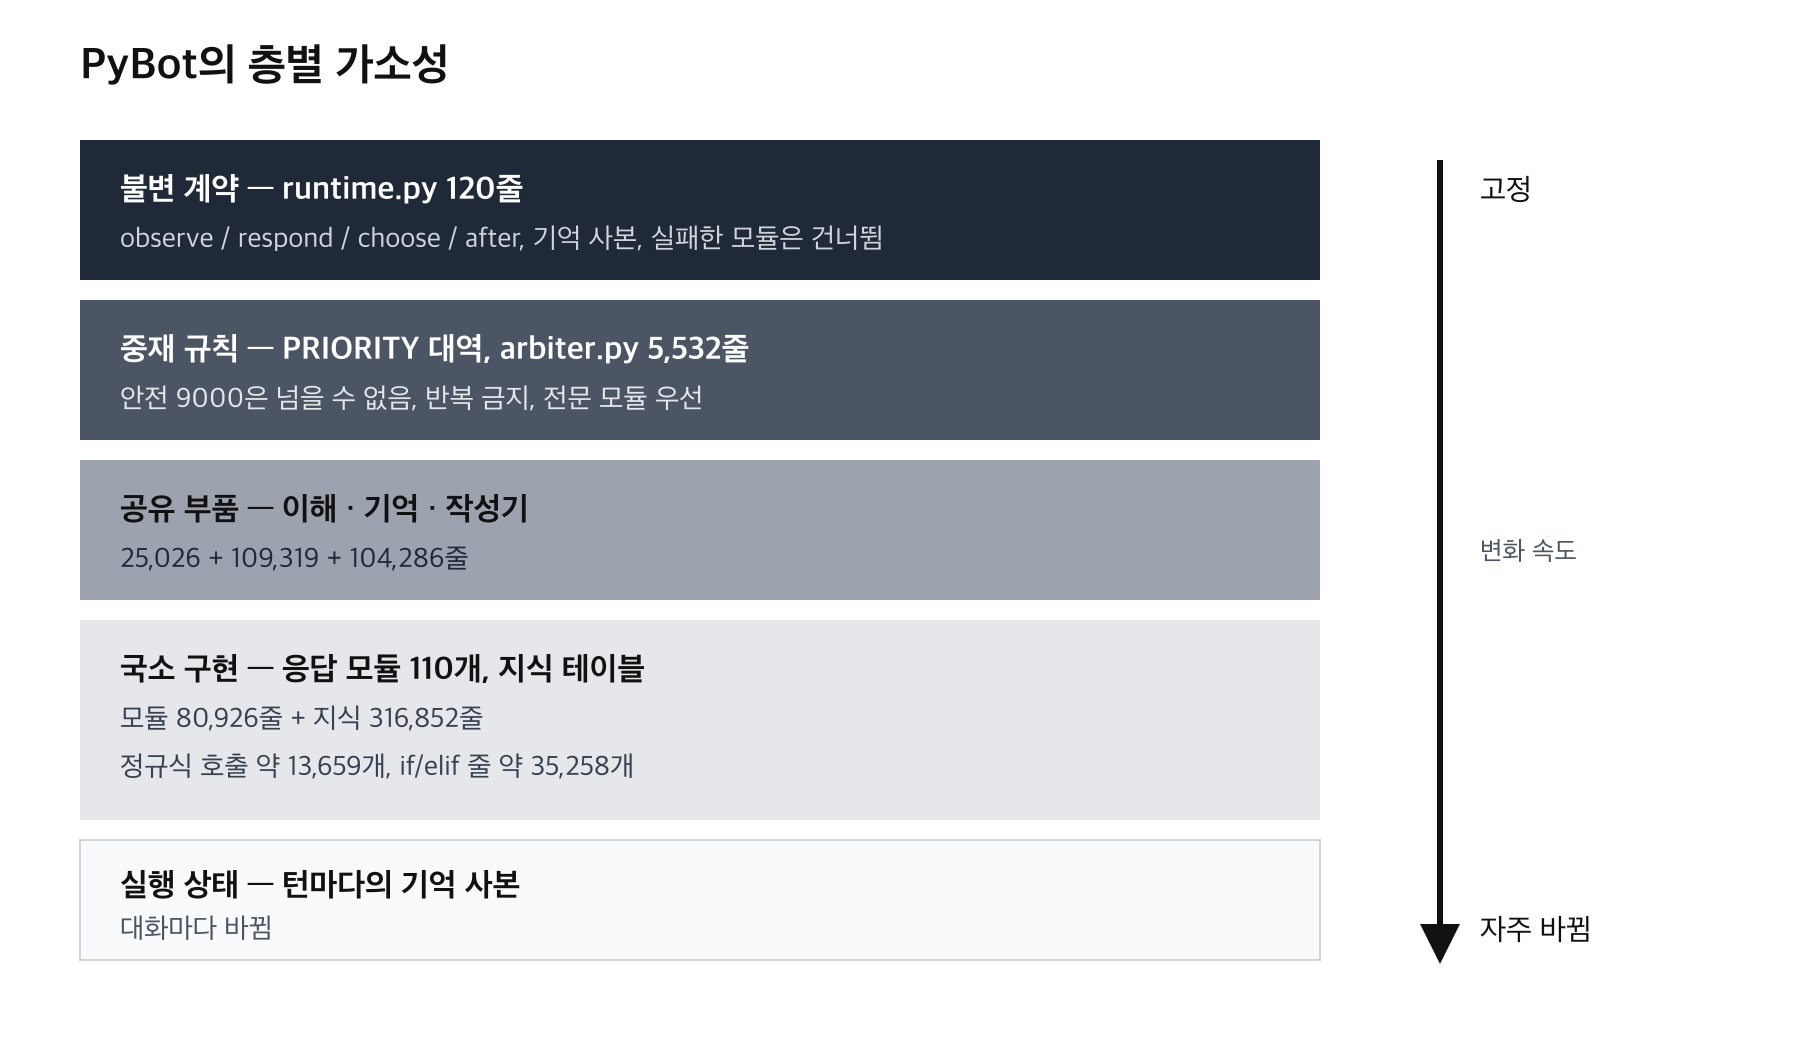
[!FIGURE] 그림 1. PyBot을 변화 속도로 나눈 층. 위로 갈수록 고정되고 아래로 갈수록 에이전트가 자주 고쳐 쓴다.
이 계약은 실행 중과 개발 중에 각각 다른 일을 한다. 실행 중에는 응답 모듈의 제안이 기억 사본에서 이뤄져 채택되지 않은 제안의 상태 변경이 대화에 남지 않고, 예외를 던진 모듈은 건너뛰어진다. 다만 턴 기록은 사본 없이 공유되고, observe와 after는 공용 기억을 받으며, 사본을 만들 수 없는 값이면 원본을 그대로 넘긴다. 격리는 응답 후보의 상태 변경과 처리 가능한 예외까지다. 개발 중에는 새 능력을 파일 하나를 bot/modules/에 넣는 것으로 추가할 수 있다. 런타임이 디렉터리를 순회하므로 다른 파일을 고칠 필요가 없다. 에이전트끼리의 수정 충돌이나 공유 부품 변경에 따른 회귀를 막는 것은 이 계약이 아니라 테스트와 평가다. runtime.py의 고정도 "never this file"이라는 규약이며, 파일 권한 같은 집행 장치는 공개 저장소에 없다.
실측: 규칙, 우선순위, 그리고 주석에 새겨진 실패
텍스트 검색으로 bot/ 전체를 세면 다음과 같다. 주석이나 문자열 안의 일치도 포함하는 근사치다.
grep -rhoE '\bre\.(search|match|fullmatch|sub|findall|compile|finditer|split)\(' bot | wc -l   # 13659
grep -rho 're\.compile(' bot | wc -l                                                           # 10181
grep -rhE '^\s*(if|elif) ' bot | wc -l                                                         # 35258
grep -rhE '^\s*def ' bot | wc -l                                                               # 10987
정규식 호출 약 1만 3천 개, if/elif로 시작하는 줄 약 3만 5천 개다. 사람이 유지보수한다고 생각하면 끔찍한 숫자다.
우선순위는 대역으로 나뉜다. 모듈 주석에 적힌 값을 모으면 다음과 같다.
[!TABLE] 표 2. 모듈
PRIORITY대역(모듈 주석 기준)
| PRIORITY | 담당 | 주석 원문 |
|---|---|---|
| 10000 | 이해(understand.py) | observes first, so every other module reads memory["understood"] |
| 9000 | 안전(safety.py) | an emergency is never outvoted |
| 7000 대 | 기억 저장소와 그 주변 | memory recall that must lead |
| 1000–3999 | 일반 도움 모듈, 상실·애도 | above small talk and the fallback |
| 0 | 지식 답변(answers.py) | — |
| −1000 | 마지막 폴백(greeting.py) | The seed's fallback: it only answers when no other module does |
중재기 arbiter.py는 5,532줄이다. 우선순위를 기본 규칙으로 두고 그 위에 예외 규칙을 쌓는다. 특정 주제를 선언한 전문 모듈이 일반 모듈을 이긴다, 직전 답을 되풀이하는 후보는 건너뛴다, 안전 대역(9000 이상)은 절대 건너뛰지 않는다 같은 규칙이다. 눈에 띄는 것은 각 규칙의 docstring이 그 규칙을 낳은 실패를 기록한다는 점이다.
* a sudden loss is answered as a loss: ... ("we lost the baby" was answered "give it a day,
  then look at what you can control", which is advice for a setback).

* a reply does not offer the food the line refused: "im trying to eat better but i hate veg" was
  answered by the balanced-meal card ("Half the plate vegetables..."), the one thing the person
  had just ruled out.
나는 적응으로서의 기억에서 에이전트의 경험은 사실보다 절차로, 즉 procedural memory로 쌓일 때 재사용된다고 썼다. PyBot에서는 그 절차가 코드이고, 그 절차를 낳은 에피소드가 주석으로 코드 옆에 붙어 있다. 사람 엔지니어의 커밋 메시지나 사고 보고서가 하던 일을 스웜은 docstring에서 한다. 다음 에이전트가 이 규칙을 지우려 할 때 왜 있는지 읽을 수 있다.
실행 관측: 무엇을 하고 무엇을 못 하는가
설치할 것은 없다. 클론해서 바로 돌린다. -s는 문장 선택을 고정하는 시드, -v는 답을 낸 모듈과 걸린 시간을 보여 준다.
git clone https://github.com/huggingface/pybot
cd pybot
printf '%s\n' "hi, i'm Sam" "what's my name?" "what is 17 times 23" | python3 -I pybot.py -s 1 -v
시작에 몇 초가 걸리고(64만 줄을 불러오므로) 한 답에 0.1~3.6초가 걸렸다. 19개 질문을 넣은 결과에서 대표적인 것을 고르면 다음과 같다.
[!TABLE] 표 3. 로컬 실행 관측(시드 1, 질문 19개 중 발췌)
| 입력 | PyBot 답(요약) | 모듈 |
|---|---|---|
| hi, i'm Sam → what's my name? | You're Sam. | memory_store |
| my kettle is full of limescale... | 식초·구연산으로 끓이는 절차와 원인 설명 | answers |
| how long does that take | Half an hour. | answers |
| what is the capital of Mongolia? | Ulaanbaatar. | answers |
| what is 17 times 23 | That's 391. | answers |
| who won the 2022 world cup? | 아르헨티나, 프랑스와 승부차기 | answers |
| explain transformers attention in one sentence | "문장"의 정의(주어와 동사…) | answers |
| summarize the plot of hamlet | Summarize the plot of hamlet — I'll remember that. | greeting |
| what is a regular expression | 수학의 "식(expression)" 정의 | answers |
| It's raining outside, what should I wear? | 러닝용 레이어링("by the first mile") | answers |
| write a python function that reverses a string | 모른다며 검색을 권함 | greeting |
맞힌 답은 놀랍도록 자연스럽다. "how long does that take"에 "Half an hour."로 답한 것은 직전 주제(석회 제거)를 기억하고 그 답의 수치를 뽑았다는 뜻이다. 틀린 답은 패턴이 분명하다. "one sentence"의 sentence, "regular expression"의 expression처럼 문장 안의 한 단어가 지식 항목의 열쇠에 걸리면 질문 전체의 의도와 상관없이 그 항목이 나온다. 비 오는 날 옷차림을 물었는데 러닝 복장이 나온 것도 같은 종류다. 코드 작성처럼 지식 베이스에 없는 범주는 마지막 폴백이 "모른다"로 받는다. 맞힌 질문도 표현에 민감하다. 벤치마크 원문 문항인 "I'm learning about adaptation in animals. What is camouflage?"는 모른다고 답했다. 적어도 문항을 그대로 외워 둔 것은 아니다.
평가가 만든 모양
PyBot의 모양을 이해하려면 무엇에 맞춰 자랐는지를 봐야 한다. SmolTalkBench 데이터셋 카드[3]에 채점 방식이 있다.
- 문항은 smoltalk의
everyday-conversations에서 뽑은 단일 턴 일상 대화 1,000개다. 참조 답은 Llama-3.1-70B-Instruct가 쓴 것이다. - 심판은
deepseek-ai/DeepSeek-V4.1-Flash이고 AlpacaEval 2.0의 비교 프롬프트를 쓴다. 점수는 PyBot 답이 더 낫다고 볼 확률이다. - WildBench식 길이 페널티가 있어 참조보다 500자 넘게 긴 답은 많아야 무승부다.
64만 줄의 구성이 이 평가와 맞물린다. 지식 베이스가 생활 주제로 채워진 것은 문항 분포와 맞물리고, 답이 짧고 단정한 것은 길이 페널티와 맞물린다. 반면 들어맞지 않는 부분도 있다. 기억 저장소가 11만 줄인데 이 벤치마크는 단일 턴이라 이전 턴을 기억하는 능력을 재지 않는다. 스웜이 다중 턴 대화를 따로 평가했는지는 공개 저장소에서 확인할 수 없다. 공개 저장소의 tests/는 명령줄만 시험하며, docstring은 봇 자체의 테스트가 스웜 저장소에 있다고 말한다. README가 말하는 에이전트 작성 테스트 55만 줄은 볼 수 없다. 수치도 문서마다 조금 다르다. README는 "over 5,000 versions"를, 카드는 "more than 6,000 commits"를 말한다. 카드는 SmolLM 기준선이 원천 대화로 학습해 점수가 부풀었다고도 밝힌다. "SmolLM-360M 수준"이라는 비교를 읽을 때 같이 봐야 할 단서다.
최적화의 기준이 보이지 않는다는 것은 이 사례의 가장 큰 공백이다. 코드는 결과이고, 그 결과를 만든 것은 평가기와 테스트, 에이전트 사이의 작업 분담(주석에 "The routing lane owns this file" 같은 문구가 남아 있다)이다. 그 부분은 비공개다.
열어 둔 층의 코드는 파라미터다
Weights, Prompts, Codes as Parameters에서 나는 가중치, 프롬프트, 코드를 정책공간의 서로 다른 층위에 놓인 넓은 의미의 파라미터로 보았다. 가중치는 역전파로, 프롬프트는 DSPy 같은 컴파일러로, 코드는 AutoHarness·Meta-Harness 같은 바깥 루프로 탐색된다. PyBot은 이 중 앞의 두 층을 아예 비우고 세 번째 층에서만 정책을 탐색한 극단적 사례다. 실행 시점에 모델이 없다. 모델은 개발 루프 안, 즉 코드를 쓰는 에이전트와 점수를 매기는 심판 쪽에만 있다.
이렇게 보면 64만 줄은 사람이 읽으려고 쓴 소스가 아니다. 학습된 가중치 행렬을 사람이 읽지 않듯, 탐색이 남긴 파라미터 덤프에 가깝다. 차이는 이 파라미터가 사람이 읽을 수 있는 언어로 쓰였다는 점뿐이다. 그래서 전통적인 코드 품질 기준을 그대로 들이대면 판단이 어긋난다. 정규식 1만 3천 개는 기술 부채이기 전에 최적화가 남긴 결정 경계다. 둘은 배타적이지 않다. 같은 규칙 집합이 경험에서 얻은 정책이면서 다음 변경을 비싸게 만드는 산출물일 수 있다. 그래서 내 주장은 조건부다. 재생성과 검증이 충분히 싸고 변경의 영향이 통제되는 층이라면, 그 층에서는 사람이 형식을 다듬는 것보다 평가 기준을 바꾸고 에이전트에게 다시 탐색시키는 쪽을 택할 수 있다. 앞에서 본 실패 기록 주석은 그 조건의 일부다. 코드는 탐색의 결과이면서 다음 탐색자가 읽는 작업 환경이므로, 이름과 모듈 경계와 실패 기록은 사람의 가독성만이 아니라 에이전트의 수정 비용을 정한다.
열어 둔 층에서 정규식 떡칠을 허용한다는 말의 정확한 의미가 이것이다. 그 층에서는 품질 판단의 대상을 코드 표면에서 실행 결과와 그 결과를 판정하는 장치로 옮기자는 말이다. 유지보수의 부담은 사라지지 않고 검증의 부담으로 이동한다. PyBot에서 그 장치는 심판 모델과 55만 줄 테스트다. 그 장치가 놓치는 것, 예컨대 "summarize hamlet"에 "기억해 두겠다"고 답하는 실패는 그대로 산출물에 남는다.
반대 방향: 가중치를 코드처럼 읽고 고친다
PyBot이 코드를 가중치처럼 다뤘다면, Weight-Space Programming은 가중치를 코드처럼 다룬다. 저자들은 지금까지 가중치를 쓰는 방법이 최적화(경사하강), 가중치를 생성하도록 학습한 별도 네트워크, 형식 프로그램을 가중치로 옮기는 컴파일러 셋뿐이었다고 정리하고, 네 번째로 범용 LLM이 자연어 목표를 받아 가중치를 직접 읽고 쓰는 방법을 제시한다. 프롬프트와 하네스 코드 같은 텍스트 산출물을 LLM으로 최적화해 온 흐름이 가중치까지 왔다는 것이 글의 문제의식이다. 공저자 Khattab은 Weights, Prompts, Codes as Parameters에서 프롬프트 공간을 여는 사례로 인용한 DSPy의 저자다.
가장 많이 알려진 실험은 실험 8[4]이다. 설정은 하네스 설계로 읽어도 될 만큼 구체적이다.
- 편집자: Codex CLI의
gpt-6-astra, reasoning effortmax. 40턴마다 새 대화로 넘기며 작업 노트와 현재 편집본을 인계한다. - 열어 둔 것: CPU 전용 Python 커널에서 텐서를 읽고 계산하고
save_edit(name, tensor)로 바꿀 수 있다. 연습 문제(GSM8K·MATH의 train)로 원본과 편집본을 비교하는 순전파 도구를 쓸 수 있다. - 닫아 둔 것: 역전파·autograd·옵티마이저 같은 학습, 커널 안에서 모델 실행, 인터넷. 그리고
save_edit는 최종 정규화층, 임베딩·출력층의 편집과 텐서 전체에 상수를 곱하는 편집을 거부한다. - 피드백 예산: 순전파 10, 25, 50회(실행별), 코드 실행 최대 300회. 이 제한은 어디를 바꿀지를 정하지 않는다. 편집자가 받는 신호의 양을 정한다.
- 채택 기준: 연습 문제에서 원본과 편집본을 비교한 순전파 결과. 편집자는 이것으로 최종 편집을 골랐다.
- 사후 평가: 제출 뒤에 돈 벤치마크. 편집자는 그 결과를 보지 못했다.
[!TABLE] 표 4. 실험 8 결과(저자 보고, 실험 저장소 README)
| 버전 | MATH-500 (%) | GSM8K (%) | IFEval (%) | 토큰 한도에 걸린 MATH-500 답 (%) |
|---|---|---|---|---|
| 편집 전 | 7.9 | 13.8 | 21.0 | 93.0 |
| 10회 | 12.3 | 25.7 | 49.0 | 87.2 |
| 25회 | 14.1 | 25.1 | 39.9 | 86.4 |
| 50회 | 48.1 | 67.1 | 62.3 | 33.1 |
50회 편집의 최종 패치는 15층과 19층 MLP 출력 행렬에서 반복(loop) 방향을 가장 많이 쓰는 열 64개씩, 가중치 131,072개를 고쳤다. Qwen 모델 카드가 이 모델이 생각 루프에 빠지기 쉽다고 경고하는 바로 그 결함이다. 토큰 한도에 걸려 답을 끝내지 못하던 비율이 93.0%에서 33.1%로 줄었고, 저자들은 점수 상승을 주로 이 반복 감소로 설명한다. 저자들은 한계도 밝힌다. 루프 문제가 거의 없는 Gemma 3 270M에 같은 하네스를 쓴 후속 실험(프롬프트와 요청당 문항 수, 채점 방식은 조금 다르다)은 MATH-500이 6.8%에서 7.0~7.7%에 머물렀다. 가중치만 보고 아첨(sycophancy) 모델을 가려내는 실험은 네 번 모두 실패했고, 어텐션 패턴을 보여 주는 도구를 준 뒤에야 성공했다. 체크포인트를 다시 만들어 돌린 Hugging Face 쪽 재실행은 MATH-500 51.0%였다고 모델 카드가 적는다.
이 실험에서 PyBot과 같은 모양을 읽을 수 있다. 편집자는 가중치 대부분을 건드릴 수 있었지만, 하네스는 임베딩·출력층·최종 정규화를 닫았고 전체 배율 조정을 막았다. 학습 루프를 금지해 변화가 편집자의 추론을 거치게 했다. 이 둘은 변화가 일어날 자리와 경로를 정하는 방향성 있는 제약이다. 순전파 횟수는 성격이 다르다. 방향 없이 피드백의 양만 정하고, 그 양이 최적화가 목적함수를 얼마나 정확히 읽는지를 정한다. 한 번의 순전파는 생성이라면 연습 문제 최대 512개를 처리하므로 50회는 적은 신호가 아니다. 표 4에서 10회와 25회 실행의 편집은 MATH-500이 12~14%였고 50회 실행의 편집은 48.1%였으며, 세 실행이 고른 편집은 모두 달랐다. 조건마다 실행이 하나씩이라 이 차이에서 예산의 효과와 실행 간 편차는 나뉘지 않는다. 50회 실행이 최종 제출한 편집은 두 층의 열 128개였다. 편집할 수 있던 영역은 훨씬 넓었지만 최적화는 그 안에서 아주 좁은 국소 편집을 골랐다. 지저분한 정규식 대신 "반복 방향을 빼라"는 한 줄짜리 선형대수지만, 구조는 같다. 닫힌 층 위에서 열린 부분의 일부가 바뀌고, 평가가 채택을 정한다.
MIRAS와 계층적 가소성
PyBot으로 돌아가면, 정규식 떡칠의 허용은 열어 둔 층에만 해당한다. 앞의 해부에서 본 것처럼 지저분함은 아무 곳에나 허용되지 않았다. runtime.py는 고치지 말라고 적혀 있고, 모듈 계약은 네 함수로 고정되어 있으며, 안전 대역은 중재기의 어떤 예외 규칙으로도 넘을 수 없다. 반면 지식 테이블과 개별 모듈의 정규식은 파일 하나를 넣고 빼는 것만으로 바꿀 수 있게 열려 있다. 표 5의 변화 속도는 이 설계가 각 층에 허용한 속도다.
생물에 비유하면 이해가 쉽다. 유전체의 모든 부위가 같은 속도로 변하지 않는다. 생존에 필수적인 부위는 잘 보존되고, 어떤 부위는 변이를 잘 견디며 환경에 따라 빠르게 달라진다. 변이를 견딜 수 있는 구조 자체가 진화 가능성(evolvability)의 조건이다. 기계학습 쪽에서는 Behrouz 등의 MIRAS[5]가 같은 문제를 메모리 설계의 언어로 다룬다. 메모리 구조, 기억이 키와 값의 관계를 어떤 손실로 맞출지 정하는 내부 목적함수(attentional bias), 무엇을 얼마나 보존할지(retention gate), 어떤 알고리즘으로 갱신할지를 분리된 설계 축으로 놓고, 보존을 새 입력에 맞춘 갱신과 과거 유지 사이의 정규화 문제로 본다. MIRAS는 파라미터 수준의 실행 중 학습을 다루지만, 핵심 질문은 같다. 어디를 얼마나 빨리 바꾸게 할 것인가.
다만 생물 비유는 구조를 보여 주는 데까지만 쓴다. 이 글은 변화를 세 겹으로 나눠 부른다. 첫째는 성질이다. 가소성은 구성요소가 얼마나 쉽게, 얼마나 빨리 바뀔 수 있느냐이고 그 반대가 안정성이다. 닫힌 층은 가소성이 0인 층이다. 둘째는 과정이다. 최적화는 최적화기가 목적함수를 기준으로, 정해진 범위 안에서 후보를 만들고 평가해 채택하는 절차다. 데이터로 파라미터를 바꾸는 학습, 학습 과정 자체를 바깥에서 바꾸는 메타학습, LLM이 추론으로 코드나 가중치를 고치는 편집이 모두 최적화의 한 종류다. 진화는 이와 다른 과정으로, 개체군 안의 변이와 유전, 세대를 넘는 선택으로 일어난다. 진화 알고리즘은 이를 본뜬 최적화다. 셋째는 결과다. 적응은 시스템이 자기 환경에 맞아 가는 관계이고, 환경을 기준으로만 말할 수 있다. 최적화가 적응이 되는 정도는 목적함수가 환경을 얼마나 대리하느냐에 달려 있다. PyBot은 SmolTalkBench 승률에 최적화되었고, 그만큼 단일 턴 일상 대화라는 환경에 적응했다. 실험 8의 편집자 하나와 MIRAS의 기억 모듈 하나는 최적화와 학습을 할 뿐 진화하지 않는다. PyBot의 스웜이 경쟁하는 개체군처럼 돌았는지, 한 코드베이스에 변경을 쌓는 조직처럼 돌았는지는 공개된 자료로 알 수 없다. 그래서 이 글에서 진화라는 말은 생물 비유와 최적화기의 이름에만 쓴다.
PyBot에 이 질문을 적용하면 다음과 같이 읽힌다.
[!TABLE] 표 5. PyBot의 층과 가소성
| 층 | PyBot에서의 실체 | 설계상 변화 속도 | 이 층이 하는 일 |
|---|---|---|---|
| 불변 계약 | runtime.py 120줄: 네 함수, 기억 사본, 예외 격리 | 고정(규약) | 모듈을 파일 단위로 넣고 빼게 한다 |
| 중재 규칙 | 우선순위 대역, arbiter.py의 예외 규칙, 안전 대역 | 느림 | 매 턴 어느 모듈의 답을 쓸지 정한다 |
| 공유 부품 | 이해 엔진, 기억, 작성기 | 중간 | 모듈들이 같은 해석을 쓰게 한다 |
| 국소 구현 | 110개 모듈, 정규식, 지식 테이블 | 빠름 | 실제 답을 만든다 |
| 실행 상태 | 턴마다의 기억 사본 | 매 턴 | 대화마다 바뀐다 |
좋은 추상화의 목적이 여기서 바뀐다. 전통적으로 추상화는 사람이 세부를 몰라도 되게 하는 장치였다. 스웜 개발에서 추상화는 에이전트가 세부를 마음대로 다시 써도 계약이 유지되게 하는 장치다. 모듈 경계는 변경의 전파를 막는 격벽이 되고, 테스트와 심판은 어떤 변경을 채택할지 정하는 평가 기준이 된다. 내가 환경으로서의 하네스에 쓴 문장, "기능을 구현하는 코드는 덜 중요해져도, 이 모든 틀의 견고함을 방어하는 코드는 중요하다"를 PyBot은 파일 단위로 보여 준다. 120줄은 방어하는 코드이고, 나머지 63만여 줄은 구현하는 코드다.
PyBot은 내 주장의 형태를 그대로 보여 준다. 정규식을 떡칠해도 되는 곳은 가소성이 높도록 설계해 열어 둔 층이다. 그 층을 둘러싼 계약과 중재 규칙, 평가 기준이 단단할수록, 안쪽은 더 마음껏 지저분해질 수 있다. 반대로 경직된 추상화를 국소 구현까지 강요하면 탐색이 막힌다. 설계의 대상은 코드 한 줄 한 줄이 아니라 층마다의 변화 속도다. 다만 수정의 국소성과 기능의 보존은 같지 않다. 파일 하나를 바꿔도 공유 기능이 넓게 달라질 수 있고, 가중치 일부만 바꿔도 여러 과제의 행동이 달라질 수 있다. 그래서 층마다 정할 것은 어디를 바꿀 수 있는지와 함께, 그 변경이 무엇을 바꿔도 되고 무엇을 유지해야 하는지다. 후자를 지키는 것이 테스트와 평가다.
프로그래밍의 새로운 패러다임
여기까지의 이야기는 사실 메타러닝이 오래 다뤄 온 주제다. 메타러닝은 Schmidhuber의 1987년 논문 "Evolutionary Principles in Self-referential Learning"에서 시작해 Thrun과 Pratt의 Learning to Learn(1998)에서 정의가 정리된, 학습 알고리즘 자체를 여러 학습 경험에 걸쳐 개선하는 분야다. Hospedales 등의 서베이 Meta-Learning in Neural Networks: A Survey[6](2021)는 이를 이층 최적화로 형식화한다.
ω* = argmin_ω  Σ_i L_meta( θ*(i)(ω), ω, D_val(i) )
s.t. θ*(i)(ω) = argmin_θ  L_task( θ, ω, D_train(i) )
안쪽에서는 과제마다 θ가 학습되고, 바깥에서는 그 학습이 검증 데이터에서 잘 되도록 ω가 학습된다. 서베이는 두 층 사이의 비대칭을 강조한다. 안쪽 학습은 ω에 조건부이지만 학습하는 동안 ω를 바꿀 수 없다. 이 글이 "닫아 둔 층"이라고 부른 것의 정식 표현이다. 서베이는 설계 공간을 세 축으로 나눈다. 무엇을 ω로 둘지(meta-representation, "What?"), 바깥 루프를 무엇으로 최적화할지(meta-optimizer, "How?"), 무엇을 기준으로 삼을지(meta-objective, "Why?")다.
세 사례를 이 틀에 놓으면 다음과 같다.
[!TABLE] 표 6. 이층 최적화로 본 세 사례
| PyBot | Weight-Space Programming(실험 8) | MIRAS | |
|---|---|---|---|
| θ: 안쪽, 빠르게 바뀌는 것 | 대화마다의 기억 사본 | 없음(추론만) | 토큰(또는 청크)마다 갱신되는 기억 모듈 |
| ω: 바깥, 느리게 바뀌는 것 | 모듈·지식 테이블의 코드 | 편집한 텐서 값 | 학습된 백본 가중치 |
| ω의 정의역 제약(닫힌 층) | runtime.py 계약, 안전 대역 | 임베딩·출력층·최종 정규화 편집 거부, 학습 루프 금지 | 기억 구조와 retention 형태 |
| meta-optimizer | 코딩 에이전트 1,000여 개 | 추론하는 LLM 하나(Astra) | 경사하강 |
| meta-objective | LLM 심판 승률 | 연습 문제 순전파(사후 벤치마크는 별도 평가) | 언어 모델 손실 |
| 바깥 질의 예산 | 5,000개 넘는 버전 평가 | 순전파 10, 25, 50회 | 학습 스텝 |
앞에서 다룬 순전파 횟수와 닫힌 층의 차이도 이 틀에서 정확해진다. 닫힌 층은 ω가 움직일 수 있는 정의역을 줄이는 제약이고, 순전파 횟수는 L_meta를 몇 번 물어볼 수 있느냐는 예산이다. 앞의 것은 탐색 공간을 바꾸고, 뒤의 것은 같은 공간에서 목적함수 추정이 얼마나 촘촘한지를 바꾼다.
부분마다 가소성이 달라야 한다는 생각도 메타러닝에서는 오래된 연구 주제다. Meta-SGD[7]는 초기값만이 아니라 파라미터마다의 학습률과 갱신 방향을 메타학습한다. 변화 속도 자체가 ω다. ANIL[8]은 MAML의 효과가 대부분 특징 재사용에서 나오며 안쪽 루프를 마지막 head에만 남겨도 된다는 것을 보였다. 몸통은 닫히고 끝만 열리는 구조가 학습 결과로 나타난 것이다. Differentiable plasticity[9]는 연결마다 가소성 계수를 두고 가중치처럼 경사하강으로 최적화했고, OML[10]은 온라인 갱신에 강하고 망각에 강한 표현을 메타 목적함수로 학습했다. MIRAS는 이 계보의 안쪽 층에 있다. Schlag, Irie, Schmidhuber[11]는 선형 어텐션이 90년대의 Fast Weight Programmer, 즉 느린 망이 빠른 가중치를 "programming instructions"로 쓰는 구조와 같다는 것을 보였다. MIRAS의 기억 모듈은 그 빠른 가중치이고, retention은 빠른 가중치가 얼마나 빨리 바뀌고 얼마나 붙잡아 둘지를 정하는 설계다. Weight-Space Programming 원문도 기존의 가중치 작성법을 정리하면서 이 논문을 링크한다.
그러면 새로운 것은 무엇인가. 표 6에서 기존 메타러닝과 달라진 행은 meta-optimizer 하나다. 서베이는 바깥 루프의 최적화기로 경사하강, 강화학습, 진화를 들고, ω가 사람이 읽을 수 있는 코드 같은 기호적 표현이면 미분할 수 없어 바깥 최적화에 주로 강화학습이나 진화를 쓴다고 정리한다. PyBot과 Weight-Space Programming은 그 자리에 LLM이 들어온 사례다. 에이전트 스웜은 미분할 수 없는 64만 줄의 기호적 ω를 탐색했고, Astra는 경사 없이 0.8B 가중치 안의 ω를 추론으로 골랐다. meta-optimizer가 LLM이 되자 코드와 가중치의 구분이 ω의 표현 차이로 줄어들었다.
Weights, Prompts, Codes as Parameters에서 나는 가중치, 프롬프트, 코드를 정책공간의 서로 다른 층위로 놓고, 층위마다 조정 비용과 피드백 속도, 검증 가능성, 위험 범위가 달라 탐색이 가중치에서 프롬프트, 코드 순으로 열렸다고 썼다. 그 구도에서 가중치는 학습 루프를 돌려야만 움직일 수 있는 층위였다. 실험 8은 이 전제를 깬다. LLM이 학습 루프 없이 가중치를 읽고 국소적으로 고칠 수 있다면, 어느 층위를 움직일지는 그 층위를 다룰 최적화기가 있느냐가 아니라 표현마다의 비용과 검증 방식으로 정해진다. 두 사례가 그 차이를 보여 준다. 실험 8은 가중치 131,072개를 고쳐 MATH-500, GSM8K, IFEval을 함께 움직였지만, 그 편집이 왜 듣는지는 평가 결과와 편집자가 단계마다 남긴 설명으로만 확인할 수 있다. PyBot은 규칙마다 생긴 이유를 docstring에 적어 둘 수 있을 만큼 읽기 쉬운 표현을 썼지만, SmolTalkBench에서 360M 모델 수준의 승률을 내는 데 64만 줄이 들었다.
이 글이 프로그래밍의 새로운 패러다임이라고 부르는 것은 사람이 직접 쓰는 대상이 동작에서 표 6의 행으로 옮겨 가는 일이다. 사람은 무엇을 실행 중에 바뀌는 θ로, 무엇을 바깥에서 최적화되는 ω로 두고 무엇을 닫을지, 어떤 최적화기를 쓸지, 무엇을 목적함수로 삼을지, 바깥 루프에 피드백을 얼마나 줄지를 정한다. 동작은 그 안에서 최적화기가 코드나 가중치로 쓴다. 두 사례에서도 이 결정은 최적화기의 바깥에 있었다. PyBot이 맞춰 간 SmolTalkBench와 심판 모델은 Hugging Face가 정했고, 실험 8에서 save_edit가 거부한 층과 순전파 예산은 실험자들이 정했다.
참고 링크 · 11
- [1] PyBot — github.com
- [2] Sparks of Weight-Space Programming — rikiyat.github.io
- [3] SmolTalkBench 데이터셋 카드 — huggingface.co
- [4] 실험 8 — github.com
- [5] MIRAS — arxiv.org
- [6] Meta-Learning in Neural Networks: A Survey — arxiv.org
- [7] Meta-SGD — arxiv.org
- [8] ANIL — arxiv.org
- [9] Differentiable plasticity — arxiv.org
- [10] OML — arxiv.org
- [11] Schlag, Irie, Schmidhuber — arxiv.org