이질적 시스템을 비교하기
최선 대 최선, 파라미터 스윕, 파레토 곡선. 100만 개의 768차원 벡터에서 pgvector HNSW와 pg_cuvs의 CAGRA를 비교하며 배운 측정 방법과 저희가 저지른 설정 실수 두 가지를 조건과 함께 싣습니다.
PGConf.Asia 2026에서 pg_cuvs를 발표하면서 pgvector의 HNSW 인덱스와 GPU에서 도는 CAGRA 인덱스를 나란히 쟀습니다. 결과는 앞선 글 "[PGConf.Asia 2026] PostgreSQL 인덱스 뒤에 GPU 두기"에 적었습니다. 이 글은 그 결과를 내는 동안 측정 방법에 대해 배운 것을 다룹니다. 주제는 세 가지입니다. 첫째는 recall과 지연과 빌드 시간이 어떻게 함께 움직이는가입니다. 둘째는 설정도 하드웨어도 다른 두 시스템을 무엇을 기준으로 맞춰 비교하는가입니다. 셋째는 recall 기준 하나에서 비교하는 대신 설정을 넓게 훑어 파레토 곡선으로 보면 무엇이 달라지는가입니다.
범위를 먼저 밝힙니다. 근거는 데이터셋 하나(Wikipedia 임베딩 100만 개, 768차원, L2 거리, 상위 10개)와 GPU 한 종류(A100 80GB)이고, 비교한 것은 pgvector 0.8.7의 HNSW와 pg_cuvs 0.9.2의 CAGRA입니다. 그래서 이 글의 내용은 벡터 검색 벤치마크의 일반 지침이 아니라 이 비교를 하며 배운 것입니다. 모든 측정은 프로젝트 안에서 했고 외부에서 재현되지 않았습니다. 수치는 발표 슬라이드와 그 원자료에서 가져왔습니다. 슬라이드는 PGConf.Asia 세션 페이지[1]에서 내려받을 수 있습니다.
대표적인 관측 하나를 조건과 함께 먼저 적습니다. 64 vCPU 서버에서 pgvector HNSW를 recall 0.99 이상에 맞췄을 때, 인덱스 설정만 바꿔도 처리량이 약 2배(초당 866개 대 1,686개), 빌드 시간이 약 3배(54초 대 157초) 달랐습니다. 여기서 처리량은 평가 질의 9,000개를 16개 세션으로 나눠 돌린 시간에서 계산한 값이고, 빌드 시간은 설정마다 5번 지은 평균입니다. "recall 0.99의 pgvector"라는 말만으로는 어느 숫자를 가리키는지 정해지지 않습니다.
수치마다 recall을 붙이는 이유
HNSW 같은 그래프 인덱스는 데이터의 일부만 보고 가까운 이웃을 찾기 때문에 진짜 이웃을 놓칠 수 있습니다. 얼마나 찾았는지는 recall로 잽니다. 진짜 상위 10개 가운데 9개를 찾았다면 recall은 0.9입니다. pgvector HNSW에서 이 정확도를 정하는 검색 설정은 hnsw.ef_search이고, 검색하는 동안 유지하는 후보 목록의 크기를 뜻합니다. 값을 키우면 더 많은 후보와 거리를 계산하므로 recall이 오르고 질의는 느려집니다.
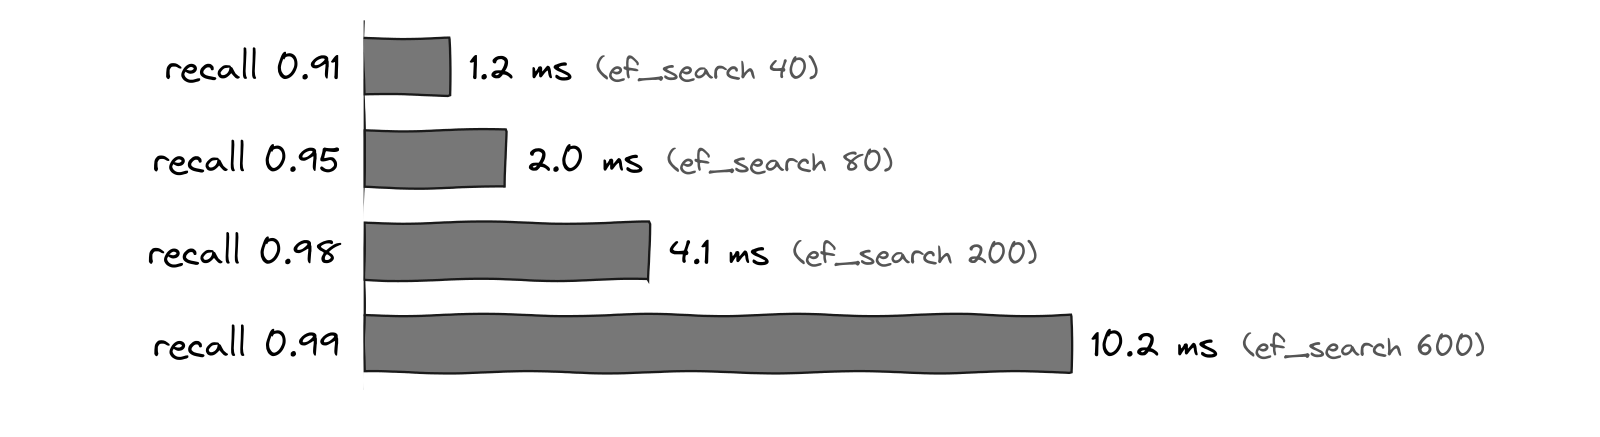
그림 1. pgvector HNSW에서 질의 하나의 중앙값 지연. pgvector 0.8.7, m = 16, ef_construction = 256, 64 vCPU 서버, 클라이언트 하나, 점마다 10초 단일 실행입니다. 발표 슬라이드의 그림입니다.
같은 인덱스에 질의를 하나씩 보냈을 때 중앙값 지연은 recall 0.91에서 약 1.2 ms, recall 0.99에서 약 10.2 ms였습니다. 약 8배입니다. 약 0.98에서 약 0.99로 올리는 데 약 6.1 ms가 더 들었는데, 약 0.98까지의 지연 전체가 약 4.1 ms였습니다. 마지막 1포인트의 recall이 그 앞 전체보다 비쌌습니다.
그래서 recall 없이 적힌 처리량이나 지연은 해석할 수 없습니다. 정확도를 조금 내주면 언제든 더 빨라질 수 있기 때문입니다. 발표에서는 비슷한 정확도끼리만 비교했고, 주 결과는 양쪽 모두 recall 0.99 이상에서 쟀습니다. 그림 1의 인덱스(ef_construction = 256)는 주 결과에 쓴 인덱스(ef_construction = 200)와 다른 빌드입니다.
같은 recall에서 빌드 시간과 처리량을 맞바꾼다
HNSW 인덱스에는 빌드할 때 정하는 설정이 둘 있습니다. m은 그래프의 층마다 벡터 하나가 갖는 최대 연결 수이고, ef_construction은 빌드하는 동안 유지하는 후보 목록의 크기입니다. 둘 다 키우면 빌드가 오래 걸립니다. 아래 표는 같은 데이터에서 네 가지 설정의 pgvector 인덱스를 recall 0.99 이상에 맞춘 결과입니다.
m / ef_construction | 빌드 시간 | recall 0.99에 닿는 ef_search | 처리량(16세션) |
|---|---|---|---|
| 16 / 128 | 54초 | 1000 | 866 QPS |
| 16 / 200 (발표의 주 결과에 쓴 설정) | 67초 | 640 | 1,210 QPS |
| 16 / 400 | 109초 | 480 | 1,470 QPS |
| 32 / 400 | 157초 | 240 | 1,686 QPS |
64 vCPU 서버(m8id.16xlarge), 병렬 빌드 워커 63개, 설정마다 5회 빌드한 평균입니다. 처리량은 평가 질의 9,000개를 16개 세션으로 나눠 돌린 시간에서 계산했고, 뒤에 나오는 pgbench 측정과는 다른 방식입니다.
이 표의 네 설정에서는 빌드에 시간을 더 들인 인덱스일수록 더 작은 ef_search로 recall 0.99에 닿았고, 그만큼 질의가 빨랐습니다. 가장 싸게 지은 16/128은 ef_search를 pgvector의 상한인 1000까지 올려야 0.99에 닿았고 처리량이 가장 낮았습니다. 이 네 설정에서는 같은 recall에서 빌드 시간을 들여 질의 처리량을 얻었습니다. 다만 빌드가 길다고 언제나 질의가 빠른 것은 아니므로, 이 관계를 다른 설정에 그대로 옮길 수는 없습니다. 표의 양 끝은 처리량이 약 1.9배, 빌드 시간이 약 2.9배 다릅니다. 이 표만 보아도 recall을 고정하면 비교가 끝난다고 말할 수 없습니다. 빌드 설정과 검색 설정이 함께 적혀야 같은 숫자를 다시 얻을 수 있습니다.
두 가지를 조심해서 읽어야 합니다. 첫째, 같은 설정으로 5번 지으면 0.99 근처의 recall이 0.3~0.7포인트 움직였습니다. 표의 ef_search는 5회 평균 recall이 0.99를 넘는 값이므로, 빌드 한 번만 보았다면 다른 값을 골랐을 수 있습니다. 둘째, 클라이언트 수를 늘려 가며 pgbench로 최고 처리량까지 반복해 잰 설정은 16/200 하나뿐입니다. 표의 더 빠른 설정들은 그렇게 재지 않았습니다. 다른 설정들을 한 번씩 훑은 측정은 뒤의 "각자의 최선끼리 견준다" 절에 적었습니다.
빌드 시간을 비교할 때도 같은 문제가 생깁니다. 100만 벡터에서 CREATE INDEX 전체 시간은 pgvector 16/200이 약 67초, CAGRA가 약 31초, GPU로 짓는 HNSW(ef_construction = 128)가 약 27초였습니다(각 5회 중앙값). 그런데 recall 0.99에 닿는 가장 싼 pgvector 빌드는 표의 16/128로 54초였습니다(5회 평균). 67초와 비교하면 GPU로 짓는 HNSW가 약 2.5배 빠르지만, 54초와 비교하면 배율이 그보다 작아집니다. 그래서 발표에서는 "GPU에서 약 27~31초, 64 vCPU에서 54~67초"라고 범위로 적었습니다. 두 HNSW의 ef_construction이 200과 128로 다르다는 점도 함께 적어야 합니다.
처리량은 지연과 함께 읽는다
동시 부하는 pgbench로 걸었습니다. 각 클라이언트는 답을 받자마자 다음 질의를 보냅니다(closed loop). 클라이언트 수를 1부터 늘려 가며 수마다 60초씩 5번 재고 중앙값을 썼습니다. GPU 쪽은 A100 한 장이 달린 24 vCPU 서버, pgvector 쪽은 별도의 64 vCPU 서버입니다. 자세한 조건과 결과 표는 앞선 글에 있습니다.
여기서 배운 것은 "최고 처리량"이 그 값을 낸 클라이언트 수와 지연 없이는 의미가 약하다는 점입니다. pgvector는 클라이언트 64개에서 최고 약 3,550 QPS였고 그때의 p99는 약 27 ms였습니다. 200 µs 배칭 창을 켠 CAGRA는 클라이언트 32개에서 최고 약 6,520 QPS였고 p99는 약 7.7 ms였습니다. 두 p99는 서로 다른 클라이언트 수에서 잰 값입니다. 그리고 최고점을 지나면 처리량은 오히려 떨어졌습니다. pgvector는 클라이언트 128개에서 약 3,130 QPS였습니다. 최고 처리량을 찾으려면 클라이언트 수를 그 지점 너머까지 늘려 봐야 합니다.
지연 예산을 먼저 정하고 읽으면 비교가 달라집니다. p99 10 ms를 예산으로 잡으면, 창을 켠 CAGRA는 클라이언트 1~32개의 모든 점이 예산 안에 들었습니다. 이번에 잰 설정(16/200, ef_search = 640)의 pgvector는 예산 안에 드는 점이 없었습니다. 클라이언트 하나일 때의 p99가 약 17 ms로 가장 낮았기 때문입니다. "약 1.8배"라는 처리량 비교와 "예산 안의 점이 없다"는 비교는 같은 측정에서 나왔지만 다른 질문에 대한 답입니다. 더 빠른 pgvector 설정을 쓰면 이 지연은 달라질 수 있습니다. 다음 절에 적은 한 번의 훑기에서 recall 0.99 이상으로 가장 빨랐던 설정은 클라이언트 하나일 때 p99가 약 11 ms였습니다.
어떤 부하에서 재느냐에 따라 좋은 설정도 달라집니다. 배칭 창은 여러 클라이언트에서 처리량을 약 4배로 올렸지만, 클라이언트가 하나뿐이면 함께 기다릴 질의가 없어서 지연만 늘었습니다. 클라이언트 하나에서 처리량은 약 1,180 QPS에서 약 890 QPS로 내려갔습니다. 한 가지 부하만 쟀다면 이 설정을 반대로 평가했을 것입니다.
설정이 다른 두 시스템은 각자의 최선끼리 견준다
pgvector의 HNSW와 CAGRA는 같은 설정으로 맞춰 놓고 잴 수 없습니다. 빌드 설정은 한쪽이 m과 ef_construction이고 다른 쪽이 graph_degree와 intermediate_graph_degree입니다. 검색 설정은 한쪽이 hnsw.ef_search이고 다른 쪽이 cuvs.itopk_size와 cuvs.search_width입니다. 하드웨어도 한쪽은 CPU 코어, 다른 쪽은 GPU 한 장이어서 같게 둘 수 없습니다. 양쪽에 똑같이 맞출 수 있는 것은 결과인 recall뿐입니다. 뒤에서 다루는 직접 호출과 PostgreSQL 경유의 비교는 같은 CAGRA 인덱스를 두 경로로 돌린 것이어서 같은 설정끼리 짝지을 수 있습니다. 서로 다른 제품 사이에는 그런 짝이 없습니다.
그래서 비교의 기준은 "같은 설정"이 아니라 "같은 recall에서 각자의 최선"이 됩니다. 이 비교가 공정하려면 제품마다 성능을 좌우하는 조정 지점을 충분히 살펴야 합니다. 이번 비교에서 저희가 값을 바꿔 가며 잰 조정 지점은 pgvector 쪽이 m, ef_construction, hnsw.ef_search였고, CAGRA 쪽이 graph_degree, intermediate_graph_degree, cuvs.itopk_size, cuvs.search_width, 배칭 창(끔과 200 µs)이었습니다. 발표의 주 결과에서는 CAGRA의 검색 쪽에서 후보 수인 cuvs.k만 100으로 정했습니다. 한쪽은 잘 맞춘 설정으로, 다른 쪽은 덜 맞춘 설정으로 돌리면, 그 차이는 두 시스템의 차이가 아니라 설정을 맞춘 정도의 차이입니다. 그 크기는 앞의 설정 표에서 볼 수 있습니다. pgvector 하나만 놓고도 recall 0.99 이상에서 설정에 따라 처리량이 약 1.9배 달랐습니다. 발표의 주 결과에서 두 시스템의 최고 처리량은 약 1.8배 차이였습니다. 두 수치는 측정 방식이 달라 곧바로 견줄 수는 없지만, 상대의 설정을 어떻게 고르느냐가 결론만큼 큰 차이를 만들 수 있다는 점은 보여 줍니다.
최선에는 설정뿐 아니라 돌리는 환경도 들어갑니다. 저희는 pgvector를 GPU 서버에 딸린 24 vCPU가 아니라 별도의 64 vCPU 서버에서 돌렸고, 병렬 빌드 워커가 63개 붙었는지 빌드마다 확인했습니다. CAGRA 쪽은 여러 클라이언트의 질의를 묶어 보내는 200 µs 배칭 창을 켰습니다. 이 창은 기본값이 꺼짐이고, 앞선 글에 적은 대로 끈 상태에서는 최고 처리량이 약 1,560 QPS였습니다.
시간이나 장비 같은 사정으로 조정 지점을 충분히 살피지 못할 때가 있습니다. 그럴 때는 살피지 못한 범위를 결과와 함께 반드시 밝혀야 합니다. 저희의 두 측정도 이 기준을 각각 절반만 채웁니다. 주 결과는 환경을 각자에게 맞췄지만 설정은 양쪽 하나씩입니다. 반대로 다음 절의 그림 2는 양쪽 설정을 넓게 훑어 recall마다 각자의 최고 처리량을 골랐지만, pgvector가 GPU 서버의 24 vCPU에서 돌았습니다.
주 결과에 쓴 pgvector의 16/200은 그 서버에서 가장 빠른 설정이 아닙니다. 발표 이틀 전에 같은 기종의 64 vCPU 서버를 따로 띄워 pgvector 설정 150개(빌드 15개, ef_search 10개)를 한 번씩 훑었습니다. recall 0.99 이상에서 가장 빠른 점은 m 36, ef_construction 256, ef_search 200이었고(recall 약 0.991), 클라이언트 64개에서 약 6,080 QPS, p99 약 18 ms였습니다. 같은 서버에서 16/200(ef_search 640)을 주 결과와 같은 조건으로 한 번(60초) 쟀을 때는 약 3,900 QPS로, 주 결과의 약 3,550 QPS보다 약 10% 높았습니다. 설정 150개를 훑은 측정은 빌드 한 번에 점마다 10초씩 한 번만 쟀고 클라이언트 수도 1개와 64개뿐이어서, 60초씩 5번 잰 주 결과와 곧바로 견줄 수 없습니다. 시간이 부족해 이 설정을 주 결과와 같은 방식으로 다시 재지 못했고, 발표에는 16/200의 수치를 실었습니다. 따라서 약 1.8배는 pgvector의 최선을 상대로 한 수치가 아니며, 설정을 더 맞춘 pgvector와는 처리량 차이가 그보다 작을 것으로 봅니다. 양쪽을 각자의 최선으로 맞춰 같은 방식으로 반복해 잰 측정은 아직 없습니다.
각자의 최선은 설정 하나를 손으로 골라서는 찾을 수 없습니다. 설정을 넓게 훑어야 하고, 다음 절이 그 방법을 다룹니다.
기준 recall 하나 대신 파레토 곡선
발표의 주 결과는 양쪽 설정 하나씩을 비교한 것입니다. pgvector는 ef_search = 640, CAGRA는 cuvs.k = 100이었고, 각 인덱스의 검색 설정은 측정 전에 보정용 질의로 골랐습니다. 이런 비교는 "recall 0.99 이상에서 이 두 설정은 어땠나"에만 답합니다. recall을 조금 낮추면 어떻게 되는지는 이 비교로 알 수 없습니다.
그 질문에 답하려면 설정을 넓게 훑고(파라미터 스윕) 파레토 곡선을 그립니다. 가능한 빌드 설정과 검색 설정의 조합을 모두 재서 점으로 찍고, 그 가운데 다른 어떤 점에도 지지 않는 점만 남깁니다. 여기서 "지지 않는다"는 recall이 더 높으면서 처리량도 더 높은(또는 지연이 더 짧은) 다른 점이 없다는 뜻입니다. 남은 점을 이으면, 각 recall에서 그 인덱스가 낼 수 있는 최선이 곡선 하나로 나타납니다.
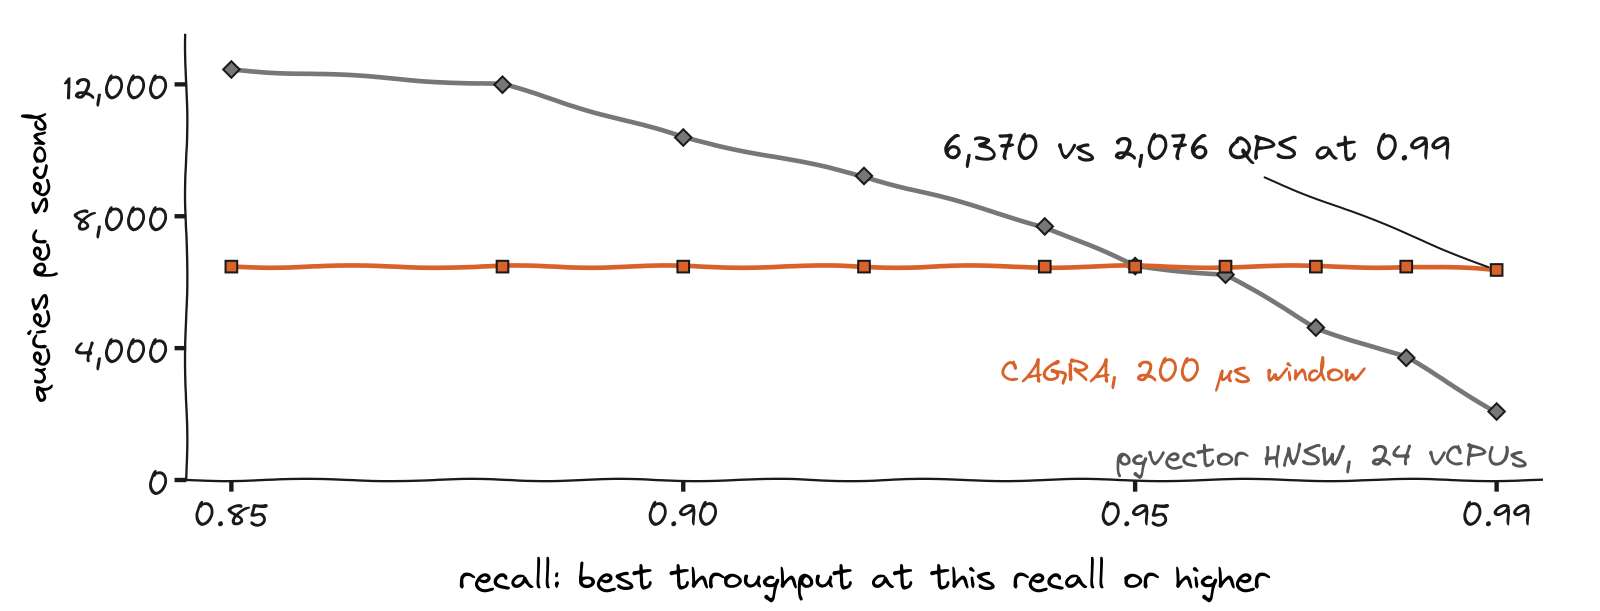
그림 2. 해당 recall 이상에서 얻은 최고 처리량. 같은 A100 서버에서 pgvector를 그 서버의 24 vCPU로 돌리고 64 클라이언트로 잰 단일 실행입니다(CAGRA 315개 설정, pgvector 150개 설정). 발표 슬라이드의 그림입니다.
그림 2의 각 점은 그 recall 이상을 내는 설정 가운데 가장 높은 처리량입니다. recall 0.99 이상에서는 창을 켠 CAGRA가 약 6,370 QPS, pgvector가 약 2,080 QPS로 약 3.1배였습니다. 0.95 이상에서는 약 6,470 대 약 6,490 QPS로 거의 같았습니다. 0.90 이상에서는 pgvector가 약 10,390 QPS로 CAGRA의 약 1.6배였고, 0.85 이상에서는 약 12,450 QPS였습니다. CAGRA의 곡선은 거의 평평했습니다. recall 0.85 이상에서 고른 최선이 0.95 이상에서 고른 최선과 같은 점이었습니다.
기준을 0.99로 잡은 비교와 0.90으로 잡은 비교는 반대 결론을 냅니다. 둘 다 측정으로는 맞습니다. 곡선 전체를 보면 어느 구간에서 어느 쪽이 앞서는지가 함께 보이고, 기준 하나의 비교는 그 곡선 위의 한 점을 고른 것이 됩니다. 발표에서 "GPU는 아주 높은 정확도가 필요한 구간에서 앞선다"고 말할 수 있었던 근거가 이 그림입니다.
이 비교에는 한계가 있습니다. 그림 2의 pgvector는 GPU 서버 자신의 24 vCPU에서 돌았고, 주 결과의 64 vCPU 서버가 아닙니다. recall 0.99에서 주 결과는 약 1.8배, 그림 2는 약 3.1배인데, 두 측정은 CPU 서버도 실행도 다르고 한쪽은 설정 하나, 다른 쪽은 곡선에서 고른 최선이므로 이 차이를 한 원인으로 돌릴 수 없습니다. 64 vCPU 서버에서 pgvector 설정을 훑은 측정은 앞 절에 적은 한 번뿐입니다. 발표에는 그 가운데 그림 1(빌드 하나, 클라이언트 하나)만 실었고, 클라이언트 64개의 결과는 넣지 못했습니다. 그 서버의 pgvector를 기준으로 두 곡선이 어디서 만나는지는 이 그림으로 알 수 없습니다. 그림 2는 격자 전체를 한 번씩만 잰 결과이기도 합니다.
두 곡선은 같은 설정의 짝으로 견준다
파레토 곡선 두 개를 한 그림에 그리면 곡선 사이의 간격을 두 경로의 차이로 읽기 쉽습니다. 저희는 PostgreSQL을 거치는 비용을 잴 때 이 점을 조심해야 했습니다. 질문은 같은 CAGRA 설정으로 cuVS를 직접 부를 때와 PostgreSQL과 pg_cuvs의 데몬을 거칠 때 질의 하나의 지연이 얼마나 다른가였습니다. cuVS 저장소에 들어 있는 벤치마크 도구인 cuVS Bench의 CAGRA 설정 격자를 같은 A100 서버에서 두 경로로 한 번씩 돌렸습니다.
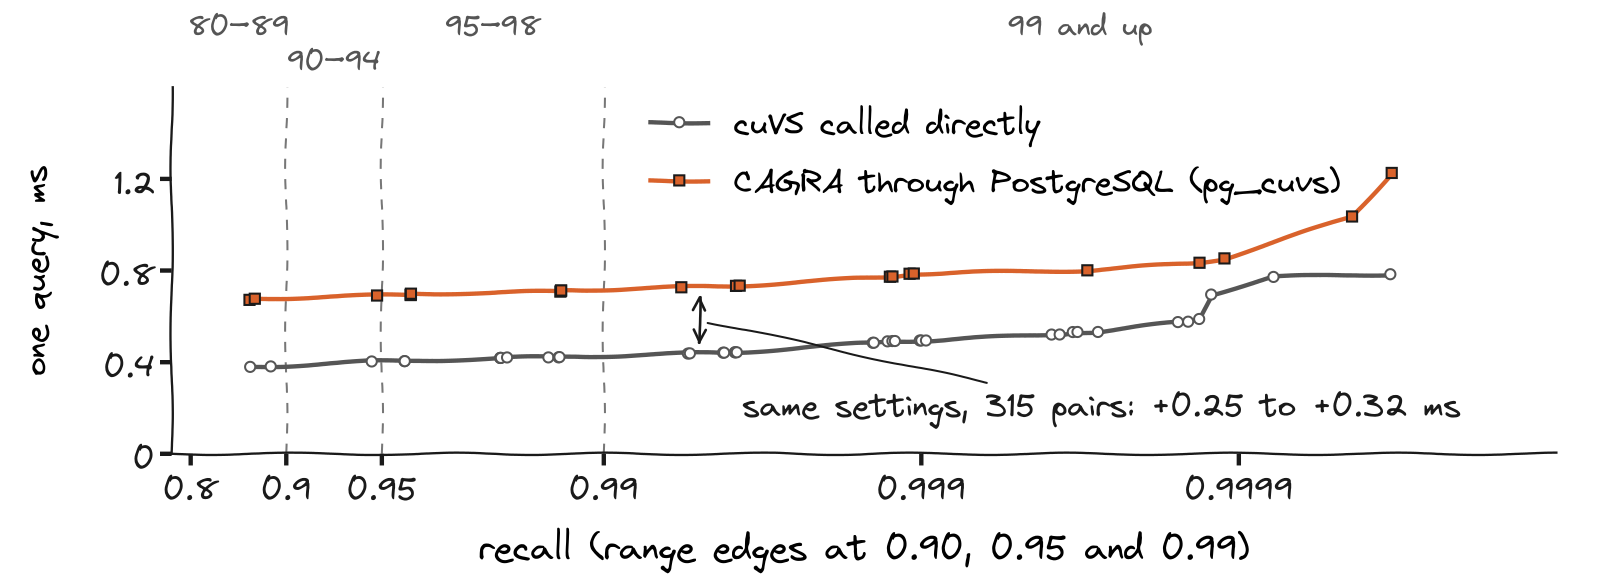
그림 3. 직접 호출(회색)과 PostgreSQL 경유(주황색)의 파레토 곡선. 같은 A100 서버(24 vCPU), 100만 x 768, 평가 질의 9,000개, 단일 실행입니다. 가로축은 recall이 1에 가까워질수록 넓게 펼쳐 그렸습니다. 발표 슬라이드의 그림입니다.
그림 3의 두 곡선은 각 경로의 파레토 선입니다. 같은 recall에서 회색 곡선 위의 점과 주황색 곡선 위의 점은 대개 서로 다른 설정입니다. 예를 들어 두 곡선의 오른쪽 끝점은 직접 호출 쪽이 graph_degree 64, 경유 쪽이 96인 빌드였고, 그 부근에서 곡선 사이가 크게 벌어집니다. 그래서 곡선 사이의 간격은 "같은 설정을 PostgreSQL로 돌리면 얼마나 느려지나"에 대한 답이 아닙니다.
그 답은 같은 설정끼리 짝지어 읽어야 나옵니다. 빌드 9개와 검색 설정 35개의 조합 315쌍 모두에서, PostgreSQL을 거친 경로는 질의당 0.25~0.32 ms(중앙값 약 0.29 ms)를 더했습니다. 직접 호출의 지연이 곡선을 따라 약 0.38 ms에서 0.78 ms로 늘어나는 동안에도 이 차이는 이 범위를 벗어나지 않았습니다. 빌드는 9개 모두에서 약 15초(14.96~15.86초) 더 걸렸습니다. 그 15초가 어디에 쓰였는지는 앞선 글에 적었습니다.
이 비교의 조건도 함께 적어야 합니다. 직접 호출 쪽은 cuVS Bench 26.04를 스레드 하나, 배치 크기 1로 돌린 평균 지연이고, PostgreSQL 쪽은 pg_cuvs 0.9.2에서 pgbench 클라이언트 하나, 배칭 창 없이 잰 중앙값(p50)입니다. 통계가 평균과 중앙값으로 다릅니다. PostgreSQL 쪽은 점마다 10초씩 한 번만 쟀고, 두 경로가 쓴 libcuvs 빌드도 공개판과 패치판으로 달랐습니다. 그림 위의 recall 구간(80~89, 90~94, 95~98, 99 이상)은 비슷한 정확도끼리 묶어 보기 위한 표시입니다.
설정 실수 두 가지
저희 벤치마크 설정에도 실수가 두 번 있었고, 둘 다 결과를 바꿨습니다. 발표에서는 시간 때문에 슬라이드에만 실었습니다. 두 실수 모두 정식 측정 이전의 실행에서 같은 64 vCPU 서버로 쟀습니다.
첫째는 pgvector의 병렬 인덱스 빌드가 63개가 아니라 6개의 워커로 돈 것입니다. 이때 100만 벡터의 빌드가 180초로 나왔고, GPU로 짓는 HNSW(25초)가 약 7.2배 빨라 보였습니다. 고친 뒤 같은 실행 조건에서 pgvector 빌드는 약 67초였고 배율은 약 2.6배였습니다. 이 67초는 앞에서 말한 정식 측정의 67초와 다른 측정입니다. 고칠 때 max_worker_processes와 테이블의 parallel_workers를 함께 바꿨기 때문에, 둘 가운데 어느 쪽이 워커 수를 묶었는지는 가르지 못했습니다.
둘째는 hnsw.ef_search에 pgvector의 상한보다 큰 값을 준 것입니다. pgvector 0.8.7의 소스에서 이 설정의 유효 범위는 1부터 1000까지이고 기본값은 40입니다. 상한을 넘는 값을 준 실행은 기본값 40으로 돌았고, 그때 잰 클라이언트 하나의 처리량 867 QPS는 recall 0.90의 수치였습니다. 같은 서버에서 recall 0.99 이상으로 맞춘 정식 측정(ef_search = 640)에서는 87 QPS였습니다. 약 10배 차이입니다.
두 실수가 결과를 바꾼 방향은 서로 반대였습니다. 첫째는 GPU 쪽을 실제보다 유리하게 보이게 했고, 둘째는 pgvector를 실제보다 빠르게 보이게 했습니다. 그 뒤 저희는 측정 절차를 다음과 같이 바꿨습니다.
- 빌드마다 실제로 붙은 병렬 워커 수를 셉니다.
- 모든 수치에 recall을 함께 기록합니다. 둘째 실수의 867 QPS도 recall 0.90과 함께 적으면 기준에 맞지 않는 수치로 드러납니다.
- 검색 설정을 고르는 질의와 결과를 재는 질의를 나눕니다.
- 비교 상대인 pgvector를 GPU 서버에 딸린 CPU가 아니라 별도의 64 vCPU 서버에서 돌리고, 5번 반복합니다.
이 비교의 한계
- 데이터셋 하나(100만 x 768), GPU 한 종류(A100 80GB), 인덱스 두 종류의 비교입니다. 다른 데이터나 다른 인덱스에서 같은 모양이 나온다는 근거는 없습니다.
- 주 결과는 양쪽 설정 하나씩의 비교이고, recall 구간 전체를 본 그림 2는 다른 CPU 서버(24 vCPU)에서 한 번만 잰 결과입니다. 64 vCPU 서버에서 pgvector 설정을 훑은 측정은 10초 단일 실행 한 번이고, 양쪽을 각자의 최선으로 맞춰 같은 방식으로 반복해 잰 측정은 아직 없습니다.
- 설정 민감도 표의 처리량은 pgbench가 아닌 근사값입니다.
- 직접 호출과 PostgreSQL 경유의 짝 비교는 단일 실행이고, 두 쪽의 통계(평균과 중앙값)와 libcuvs 빌드가 다릅니다.
- 금액으로 본 비용은 비교하지 않았습니다.
- 모든 측정은 프로젝트 안에서 했고 외부에서 재현되지 않았습니다.
pg_cuvs의 코드는 pg-cuvs/pg_cuvs[2]에 있습니다.
참고 링크 · 2
- [1] PGConf.Asia 세션 페이지 — pgconf.asia
- [2] pg-cuvs/pg_cuvs — github.com