벡터 삽입 후 HNSW 검색 재현율은 어떻게 달라질까? (100만+100만)
pgvector와 Qdrant에 신규 벡터 100만 개를 추가하고, 삽입 순서·분할과 fresh 인덱스의 Recall 차이를 측정했습니다. 실제 세그먼트 기록과 소스 코드로 서로 다른 거동을 해석합니다.
앞선 글에서는 기존 1만 벡터에 신규 1만 개를 추가했습니다. 삽입 순서와 배치를 바꾸어도 같은 최종 데이터로 새로 만든 인덱스와의 Recall 차이는 작았습니다. 이번에는 같은 질문을 100만+100만 벡터로 확장했습니다.
결과의 방향부터 달랐습니다. pgvector의 Recall@100은 삽입 후 내려갔고 Qdrant는 올라갔습니다. 같은 구축 설정을 적용한 결과에서도 이 차이는 남았습니다. 실행 기록을 더 살펴보니 Qdrant는 초기와 최종에 서로 다른 수의 HNSW 그래프를 검색하고 있었습니다.
이 글은 그 관측을 삽입 이력, 입력 순서와 분할, 각 제품의 인덱스 구조 순서로 설명합니다.
먼저 세 상태를 비교했습니다
공개 MS MARCO SimANS의 768차원 float32 벡터를 사용했습니다. 검색 거리는 원본 벡터의 내적입니다. 기존 100만 개로 인덱스를 만든 뒤 같은 신규 100만 개를 추가하고, 동일한 최종 200만 개를 별도로 적재해 신규 구축한 fresh 인덱스와 비교했습니다. 기존 인덱스에 재색인을 실행한 전후 실험은 아닙니다.
| 항목 | 설정 |
|---|---|
| 제품 | PostgreSQL 17 / pgvector 0.8.7, Qdrant 1.17.1 |
| HNSW 구축 | 두 제품 모두 M=16, ef_construction=100 |
| 검색 ef | 100, 128, 256, 512, 1000 전체 |
| 평가 | 입력 시드 11, 같은 질의 200개 |
| 구축 반복 | 조건별 1회 |
| 정답 | 각 시점의 실제 벡터 집합에서 계산한 exact top-100 |
두 제품은 같은 종류의 CPU VM에서 별도로 실행했습니다. 아래 대표 수치는 검색 ef=256, Recall@100입니다.
| 상태 | pgvector | Qdrant |
|---|---|---|
| 초기 100만 개 | 76.880% | 81.705% |
| 무작위 순서로 100만 개 추가 | 74.685% | 83.745% |
| 최종 200만 개의 fresh | 74.655% | 83.155% |
| 삽입 후 − 초기 | −2.195%p | +2.040%p |
| 삽입 후 − fresh | +0.030%p | +0.590%p |
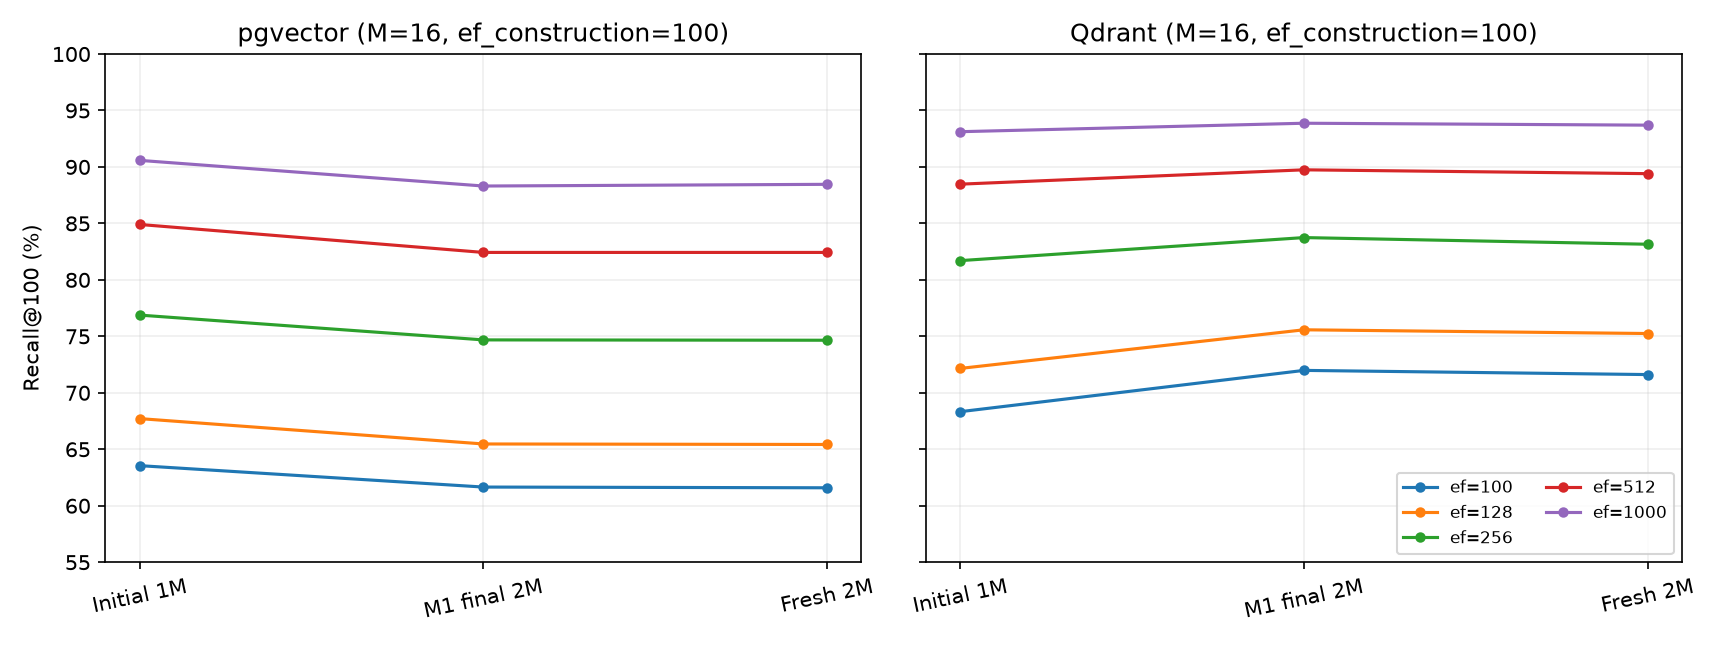
두 제품의 다섯 ef를 모두 표시했습니다. 같은 색의 선은 같은 검색 ef입니다.
pgvector는 삽입 전보다 2.195%p 낮았지만, 같은 최종 데이터의 fresh와는 0.030%p 차이였습니다. Qdrant의 전후 상승분은 2.040%p였고 fresh와의 차이는 0.590%p였습니다. 검색 대상과 정답 이웃도 바뀌므로 전후 변화 전체를 인덱스의 열화나 개선으로 읽기 어려운 이유입니다.
전체 경로와 다섯 ef에서 증분−fresh Recall@100 차이는 pgvector −0.730~+0.480%p, Qdrant −0.755~+0.670%p였습니다.
같은 벡터를 어떤 순서로, 몇 번에 나누어 넣었나
신규 100만 개에 두 가지 순서를 만들었습니다. 무작위 순서와, spherical k-means로 나눈 다섯 클러스터를 차례로 넣는 순서입니다. 클러스터는 정규화한 사본으로 만들었고 DB에는 원본 벡터를 넣었습니다.
| 경로 | 삽입 순서 | 논리 배치 |
|---|---|---|
| M1 | 전체 무작위 순서 | 1회 |
| M5 | M1과 같은 순서 | 5회 |
| C1 | 클러스터별 순서 | 1회 |
| C5 | C1과 같은 순서 | 5회 |
다섯 배치의 크기는 353,849 / 124,116 / 254,129 / 173,389 / 94,517개입니다. M5도 같은 크기로 나눴습니다. 각 제품의 네 경로는 같은 초기 인덱스 스냅샷에서 시작했습니다. 실제 전송은 모두 1,000개 단위였고, 다섯 배치 경로는 배치 사이에 안정화와 검색을 거쳤습니다.
ef=256에서 최종 Recall@100의 경로 차이는 다음과 같았습니다.
| 비교 | pgvector | Qdrant |
|---|---|---|
| 무작위 5회 − 1회: M5−M1 | +0.450%p | +0.080%p |
| 클러스터 5회 − 1회: C5−C1 | +0.005%p | +0.160%p |
| 1회에서 클러스터 − 무작위: C1−M1 | +0.150%p | −0.830%p |
| 5회에서 클러스터 − 무작위: C5−M5 | −0.295%p | −0.750%p |
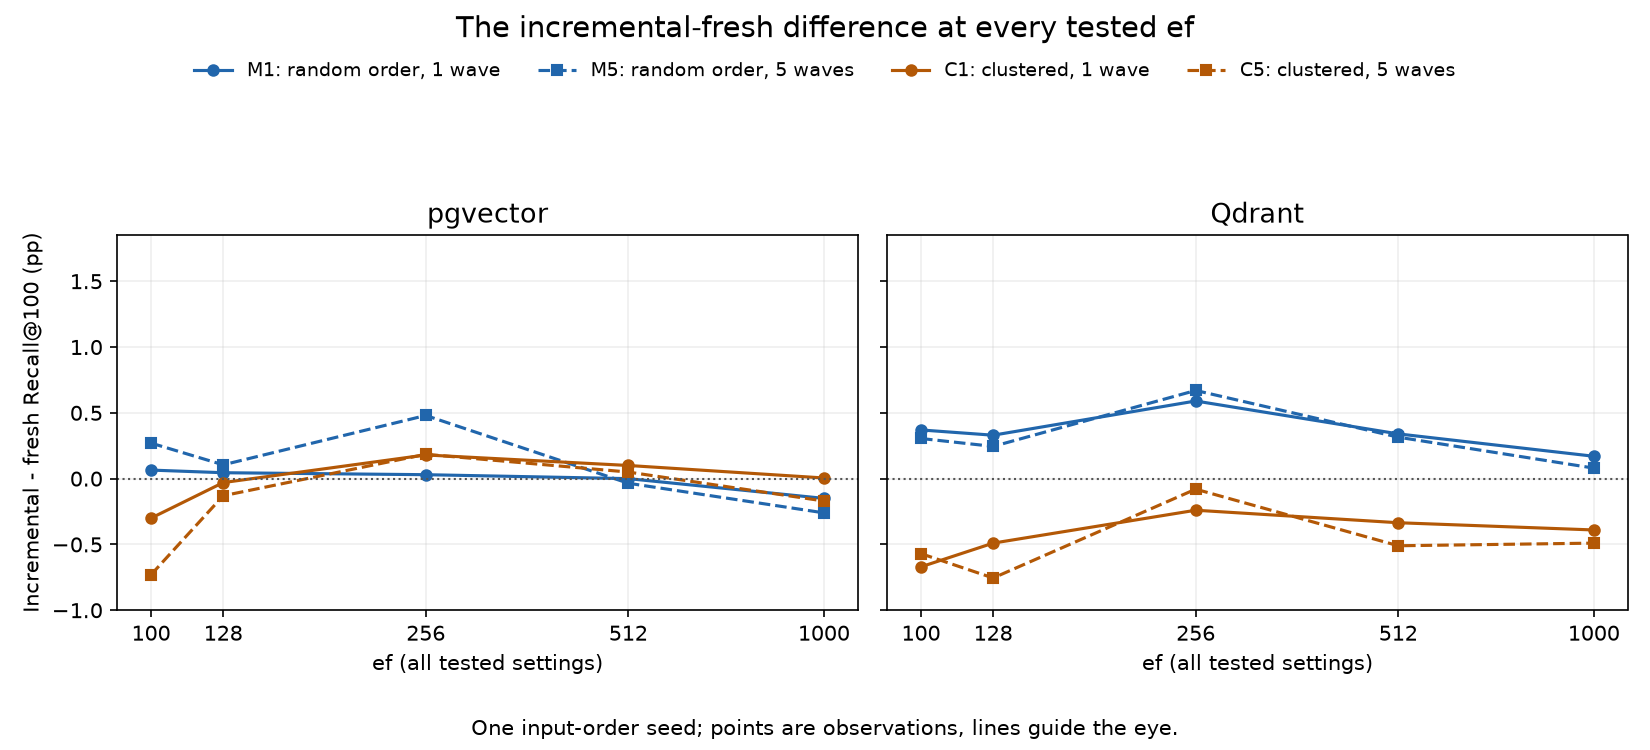
파란색은 무작위 순서, 갈색은 클러스터 순서입니다. 실선은 1회, 파선은 5회 삽입이며 세로축은 증분−fresh Recall@100 차이(%p)입니다.
Qdrant에서는 측정한 다섯 ef 모두에서 클러스터 순서가 같은 배치 수의 무작위 순서보다 낮았습니다. pgvector는 ef에 따라 순서 차이의 부호가 바뀌었습니다. 분할도 일관된 방향은 아니었습니다. Qdrant의 M5−M1은 ef=256에서만 양수였고 나머지는 음수였습니다.
페이지가 늘어나는 것과 그래프가 늘어나는 것
pgvector의 HNSW는 PostgreSQL의 여러 페이지에 걸쳐 저장됩니다. 노드의 이웃 목록이 다른 페이지의 노드를 가리키므로 페이지 경계를 넘어 연결된 하나의 논리적 그래프입니다. 신규 벡터는 기존 그래프에서 이웃을 찾고 연결을 갱신합니다. pgvector 자료구조[1], 삽입 코드[2]
Qdrant의 세그먼트는 벡터·메타데이터·인덱스를 함께 관리하는 단위입니다. 세그먼트별로 독립적인 HNSW를 검색하고 그 후보를 합칩니다. 신규 데이터는 쓰기 가능한 세그먼트에 들어가고, 백그라운드 optimizer가 인덱싱과 병합을 수행합니다. Qdrant 검색 코드[3], Indexing optimizer[4]
실험에서 만든 다섯 클러스터와 Qdrant의 세그먼트는 별개입니다. 실제 세그먼트 경계는 Qdrant가 정합니다.
실제로 두 그래프가 세 그래프로 바뀌었습니다
완료된 Qdrant M1의 원시 텔레메트리를 확인했습니다.
| 상태 | 비어 있지 않은 HNSW 세그먼트 | 각 세그먼트의 벡터 수 | 200질의의 HNSW 카운터 증가 |
|---|---|---|---|
| 초기 1M | 2 | 683,000 / 317,000 | 400 |
| 삽입 후 2M | 3 | 683,000 / 683,000 / 634,000 | 600 |
| fresh 2M | 3 | 683,000 / 683,000 / 634,000 | 600 |
각 상태에는 빈 세그먼트가 하나 더 있었습니다. 비어 있지 않은 세그먼트마다 HNSW 검색 카운터가 200씩 증가했고, plain·exact 검색 카운터 증가는 0이었습니다. 초기 세그먼트 식별자 하나는 최종에도 남았고 다른 하나는 새 세그먼트들로 교체됐습니다.
이 기록은 같은 ef=256이 초기와 최종에 같은 탐색 구조로 적용되지 않았음을 보여줍니다. 초기에는 두 그래프, 최종에는 세 그래프를 독립적으로 검색했습니다.
세그먼트별 탐색은 Qdrant에서 Recall이 올라간 현상을 설명하는 유력한 요인입니다. 다만 ef는 방문 노드 수가 아닙니다. 세 그래프의 ef=256을 정확히 768개 노드 방문이나 세 배의 연산량으로 계산할 수는 없습니다. 최종 M1과 fresh도 모두 세 그래프를 검색했지만 Recall에는 0.590%p 차이가 남았습니다. 그래프 수 외에 각 세그먼트의 벡터 구성과 연결도 봐야 합니다.
결과를 합치면 정답을 잃지 않을까
각 세그먼트에서 정확한 top-100을 구하고 그 후보를 모아 전체 top-100을 고르면, 전체 데이터를 정확 검색한 결과와 같습니다. 자기 세그먼트의 top-100 밖에 있는 벡터는 그 안에만 더 좋은 벡터가 100개 있으므로 전체 top-100에도 들 수 없습니다.
ANN에서는 각 그래프가 정답 후보를 얼마나 찾았는지가 중요합니다. 이번 Qdrant는 모든 비어 있지 않은 세그먼트를 검색했습니다. 여러 독립된 그래프에서 후보를 얻는 구조가 하나의 큰 그래프보다 유리하게 작용할 가능성이 있습니다.
이 저장·유지보수 방식은 ClickHouse MergeTree의 part와 닮았습니다. 작은 단위로 받아 백그라운드에서 병합하고, 질의에서 여러 단위의 결과를 합칩니다. 다만 MergeTree part는 불변인 반면 Qdrant에는 쓰기 가능한 세그먼트가 있습니다. 일반적인 MergeTree의 정확한 질의와 달리 HNSW에서는 병합으로 그래프와 탐색 개수가 바뀌면서 Recall도 달라질 수 있습니다. ClickHouse part 설명[5]
클러스터 순서는 왜 두 제품에서 다르게 작용했을까
Qdrant에서는 클러스터 순서가 다섯 ef 모두에서 불리했습니다. pgvector에서는 그처럼 일관된 불이익이 나타나지 않았습니다. 이 차이를 이해하려면 입력 순서가 최종 인덱스에 남는 방식을 봐야 합니다.
pgvector는 새 벡터마다 기존 HNSW에서 이웃을 찾고 연결합니다. 기존 노드의 이웃 목록에도 새 노드를 반영하며, 연결 수가 한도를 넘으면 이웃을 다시 선별합니다. 실제 코드의 HnswFindElementNeighbors → UpdateGraphOnDisk 경로입니다. 클러스터 A 다음에 B를 넣어도 B는 초기 100만 벡터와 먼저 삽입한 벡터가 연결된 공통 그래프에서 이웃을 찾습니다. pgvector 삽입 코드[2], 이웃 갱신 코드[6]
초기 그래프가 신규 클러스터의 영역을 이미 충분히 연결하고 있었다면, 그 연결이 순서의 영향을 완화했을 수 있습니다. 다섯 번으로 나누어도 같은 그래프를 계속 갱신한다는 점도 같습니다. pgvector에서도 HNSW의 연결 형성은 순서에 의존하지만, 이번 결과에는 클러스터 순서에 따른 일관된 Recall 저하가 없었습니다.
Qdrant에서는 순서가 세그먼트의 벡터 구성에도 영향을 줄 수 있습니다. 무작위 유입과 클러스터별 유입은 optimizer가 작업하는 시점에 서로 다른 분포의 벡터를 세그먼트에 모을 수 있습니다. 각 HNSW는 그 안의 벡터로 이웃을 선택합니다. 배치 사이에 최적화를 기다리면 어느 데이터가 함께 인덱싱·병합되는지도 달라질 수 있습니다. 구축에는 기존 그래프를 재사용·복구하는 경로와 병렬 삽입이 있습니다. 세그먼트 최적화 코드[7], HNSW 구축 코드[8]
이번 최종 M1과 C1은 그래프가 모두 3개였고 크기도 683,000 / 683,000 / 634,000개로 같았습니다. 그런데 C1의 Recall@100은 ef=256에서 0.830%p 낮았습니다. 따라서 그래프 개수만으로 이 순서 차이를 설명할 수는 없습니다. 세그먼트별 벡터 구성과 그 안에서 형성된 연결이 달랐다는 설명이 가능합니다. 모든 세그먼트를 검색했으므로, 각 그래프가 정답 후보를 얼마나 찾았는지가 중요합니다.
이것이 Qdrant에서 순서 효과가 나타날 수 있는 구조적 경로입니다. 다만 비슷한 벡터를 모은 그래프가 검색하기 쉬워지는 경우도 있습니다. 이번에 클러스터 순서가 불리해진 구체적인 원인은 세그먼트별 벡터 구성과 연결을 아직 대조하지 않아 확정하지 못했습니다.
평균 차이와 질의별 차이
Qdrant의 원시 검색 결과를 동일한 정답과 질의별로 대조했습니다. 아래는 ef=256에서 왼쪽 경로의 Recall@100이 오른쪽보다 낮거나 같거나 높은 질의 수입니다.
| 비교 | 평균 차이 | Recall 낮음 | Recall 동률 | Recall 높음 |
|---|---|---|---|---|
| C1−M1 | −0.830%p | 108 | 29 | 63 |
| C5−M5 | −0.750%p | 105 | 27 | 68 |
| M5−M1 | +0.080%p | 80 | 38 | 82 |
M5와 M1은 평균 차이가 0.080%p였지만 200개 중 162개 질의에서 Recall이 달랐습니다. 클러스터 순서에서도 Recall이 낮아진 질의가 더 많았으나 개선된 질의가 함께 있었습니다. 작은 평균 차이 안에서도 개별 질의가 겪은 변화는 서로 달랐습니다.
Qdrant에서는 높은 구축 설정에서도 클러스터 순서가 불리했습니다
Qdrant에서 클러스터 순서가 불리했던 결과가 M=16, ef_construct=100에만 나타났는지도 살펴봤습니다. 기존 M=48, ef_construct=300 실행에서도 같은 배치 수끼리 비교하면 클러스터 순서가 무작위 순서보다 낮았습니다. 이 관계는 두 구축 설정의 다섯 검색 ef 모두에서 같았습니다.
ef=256의 경로 차이를 나란히 놓으면, 유지된 관계와 달라진 관계가 구분됩니다. 단위는 Recall@100의 %p입니다.
| 비교 | M=16, ef_construct=100 | M=48, ef_construct=300 |
|---|---|---|
| 1회에서 클러스터 − 무작위: C1−M1 | −0.830 | −0.215 |
| 5회에서 클러스터 − 무작위: C5−M5 | −0.750 | −0.335 |
| 무작위 5회 − 1회: M5−M1 | +0.080 | −0.725 |
| 클러스터 5회 − 1회: C5−C1 | +0.160 | −0.845 |
높은 설정에서 클러스터 순서의 불이익은 이 ef에서 작아졌지만 사라지지는 않았습니다. 반면 분할의 영향은 달랐습니다. 높은 설정에서는 무작위와 클러스터 순서 모두 다섯 번 나눠 넣은 쪽이 한 번에 넣은 쪽보다 낮았고, 이 관계가 다섯 ef 모두에서 유지됐습니다. 특히 C5는 네 삽입 경로 중 가장 낮았습니다.
여기서 fresh와 무작위 삽입을 구분할 필요가 있습니다. 높은 설정의 C1은 fresh보다 0.675%p 높았지만, 무작위 M1보다 0.215%p 낮았습니다. fresh보다 높았다는 사실이 클러스터 순서가 더 좋았다는 뜻은 아닙니다. 같은 최종 데이터에서도 새로 구축한 인덱스와 각 삽입 경로는 서로 다른 결과를 냈습니다.
새로 구축하면 Recall이 높아졌을까
이번 100만+100만 실험에서 신규 벡터를 추가한 인덱스는 fresh보다 일관되게 낮지 않았습니다. 두 제품의 M=16, ef_construction=100 조건에서 증분−fresh 차이는 모두 1%p 이내였고, 양수와 음수가 함께 나왔습니다. pgvector의 무작위 1회 삽입은 ef=256에서 fresh와 0.030%p 차이였으며, Qdrant의 무작위 삽입은 다섯 ef 모두 fresh보다 높았습니다. 이 비교에서는 최종 200만 개로 새로 구축하는 것이 Recall을 일관되게 높여주지 않았습니다.
삽입 전후에는 분명한 변화가 있었습니다. pgvector의 무작위 1회 삽입은 초기보다 2.195%p 내려갔습니다. 그런데 fresh도 거의 같은 수준이었습니다. 삽입 전보다 낮아졌다는 이유로 하락분 전체를 기존 그래프의 열화로 해석하면, 검색 대상과 정답 이웃이 달라진 영향까지 포함하게 됩니다.
Qdrant에서는 반대로 삽입 후 Recall이 올랐습니다. 그 과정에서 검색하는 독립 HNSW 그래프도 두 개에서 세 개로 늘었습니다. pgvector가 하나의 연결된 그래프에 노드를 추가하는 동안, Qdrant는 세그먼트 구성을 바꾸고 여러 그래프에서 후보를 얻었습니다. 따라서 같은 ef를 유지한 채 데이터를 추가해도 검색 구조는 그대로가 아니었습니다. 이 차이는 두 제품에서 삽입 후 Recall의 방향이 달랐던 현상을 설명하는 한 요인입니다.
삽입 방식에도 차이가 남았습니다. Qdrant에서는 클러스터별 순서가 두 구축 설정 모두에서 무작위 순서보다 불리했습니다. pgvector에서는 클러스터 순서에 따른 일관된 불이익이 관찰되지 않았습니다. 나눠 넣기도 공통된 이점을 보이지 않았고, 높은 Qdrant 설정에서는 오히려 두 순서 모두 불리했습니다. 이번 결과에서 벡터 추가가 곧 인덱스 열화로 이어지지는 않았지만, 같은 벡터를 넣더라도 순서와 분할 방식에 따라 최종 Recall은 달라졌습니다.
참고 링크 · 8
- [1] pgvector 자료구조 — github.com
- [2] 삽입 코드 — github.com
- [3] Qdrant 검색 코드 — github.com
- [4] Indexing optimizer — github.com
- [5] ClickHouse part 설명 — clickhouse.com
- [6] 이웃 갱신 코드 — github.com
- [7] 세그먼트 최적화 코드 — github.com
- [8] HNSW 구축 코드 — github.com