AI / Agent
작업공간을 갖춘 범용 작업자: Managed Agents와 OpenAI Agents API
Anthropic Managed Agents와 OpenAI Agents API가 제품군에 더한 층이 무엇인지, 두 런타임 API가 어떤 추상화로 수렴했는지, 같은 작업을 두 API에서 실행한 기록과 함께 로컬 하니스와 클라우드 코딩 제품까지 비교한다
Anthropic의 공식 문서는 Claude로 무언가를 만드는 길을 두 가지로 소개합니다. 하나는 모델을 직접 부르는 Messages API이고, 다른 하나는 Claude Managed Agents입니다. 문서는 Managed Agents를 "관리형 인프라에서 도는, 미리 만들어지고 설정할 수 있는 에이전트 하니스"라고 설명합니다. OpenAI의 문서도 비슷한 갈래를 표로 보여 줍니다. 모델을 직접 다루는 Responses API, 애플리케이션 안에서 에이전트 루프를 돌리는 Agents SDK, 그리고 "OpenAI가 관리하는 Codex 하니스"를 돌리는 Agents API입니다.
두 회사가 같은 방향으로 층을 하나씩 더한 셈입니다. 지금까지 모델 제공자는 토큰을 팔았고, 에이전트 루프, 도구 실행, 샌드박스, 상태 저장은 개발자가 만들었습니다. Claude Code나 Codex 같은 도구가 그 루프를 내 컴퓨터에서 돌려 주었고, Agent SDK가 그 루프를 라이브러리로 열었습니다. Managed Agents와 Agents API는 한 걸음 더 나갑니다. 루프와 실행 환경과 세션 상태를 제공자 서버로 가져가고, 그것을 프로그램이 다룰 API 리소스로 내놓습니다.
이 글은 이 변화를 세 방향에서 봅니다. 첫째, 제공자가 맡는 범위가 어디까지 넓어졌는지 계층별로 정리합니다. 둘째, 두 회사의 런타임 API가 어떤 추상화로 수렴했는지 봅니다. 같은 피보나치 작업을 두 API에서 실제로 돌린 기록이 이 부분의 근거입니다. 셋째, 이 층이 생기면서 개발자가 얻는 것과 넘겨주는 것을 따집니다.
직접 호출한 것은 Claude Managed Agents, Claude Agent SDK, OpenAI Responses API, OpenAI Agents API(환경 none과 openai_hosted)입니다. OpenAI Agents SDK, 두 회사의 자체 호스팅 환경, Claude Code 클라우드 세션, Codex Cloud는 공식 문서로만 다룹니다. 2026-10-23 기준이고, 두 API 모두 베타입니다.
1. 제공자가 맡는 범위가 넓어지고 있다
에이전트 하나를 돌리려면 다섯 가지가 필요합니다. 모델 추론, 도구를 고르고 결과를 다시 모델에 넘기는 루프(하니스), 명령과 파일 작업이 실제로 일어나는 실행 환경, 대화 기록과 작업 결과를 담는 세션 상태, 그리고 작업을 시작시키는 신호와 사람이 결과를 보는 화면입니다. 지금 두 회사의 제품군은 이 다섯 가지를 누가 맡느냐에 따라 네 층으로 나뉩니다.
| 맡는 일 | 모델 API (Messages, Responses) | 로컬 하니스 (claude -p, Claude Agent SDK, Codex 로컬 실행, OpenAI Agents SDK) | 호스팅 런타임 API (Managed Agents, Agents API) | 클라우드 코딩 제품 (Claude Code 클라우드, Codex Cloud) |
|---|---|---|---|---|
| 모델 추론 | 제공자 | 제공자 | 제공자 | 제공자 |
| 도구 루프 | 나 | 제공자가 만든 코드가 내 컴퓨터나 내 앱에서 돈다 | 제공자 | 제공자 |
| 실행 환경 | 나 | 내 컴퓨터, 또는 내가 고른 샌드박스 | 제공자 샌드박스, 또는 내 인프라 | 제공자 VM |
| 세션 상태 | 나 (OpenAI는 Conversations 등 선택 가능) | 내 컴퓨터나 내 저장소 | 제공자 서버 | 제공자 서버 |
| 시작 신호와 화면 | 나 | 터미널이나 내 앱 | 내 코드 (웹훅과 예약 실행은 제공자가 지원) | 제공자의 웹, 모바일, 데스크톱 화면 |
표의 오른쪽으로 갈수록 제공자가 맡는 칸이 늘어납니다. 호스팅 런타임 API가 새로운 점은 하니스, 실행 환경, 세션 상태를 제공자가 맡으면서도 화면은 맡지 않는다는 것입니다. 대신 그 세 가지를 프로그램이 조합할 수 있는 리소스로 내놓습니다. 클라우드 코딩 제품은 같은 층들을 사람이 쓰는 화면으로 묶은 것이고, 호스팅 런타임 API는 그것을 프로그램용 부품으로 푼 것이라고 볼 수 있습니다.
OpenAI 문서는 이 관계를 직접 드러냅니다. Agents API가 돌리는 것이 "관리되는 Codex 하니스"라고 적고, 자동 컨텍스트 압축, 멀티에이전트 오케스트레이션, 프로그래매틱 도구 호출, MCP 서버 지원을 그 기능으로 듭니다. Anthropic 문서는 Managed Agents의 하니스가 내장 프롬프트 캐싱과 압축을 지원한다고 설명하지만, 그 하니스를 Claude Code라고 부르지는 않습니다. 두 회사의 호스팅 하니스가 각자의 코딩 제품과 같은 코드인지는 이 글에서 확인하지 못했습니다. 위의 해석은 문서의 구분과 이름을 근거로 한 것입니다.
2. 두 런타임 API는 같은 추상화로 수렴했다
두 API를 나란히 놓으면 이름과 경로는 달라도 뼈대가 같습니다. 설정(에이전트)과 실행(세션)을 나누고, 그 사이에 실행 환경을 두고, 대화 기록을 제공자 서버에 남기고, 결과 파일을 정해진 디렉터리에서 API로 꺼냅니다. 아래 표의 엔드포인트와 응답 형태는 직접 호출로 확인한 것입니다. 기본 도구와 예산 항목은 문서 기준입니다.
| 개념 | Claude Managed Agents | OpenAI Agents API |
|---|---|---|
| 베타 표식 | anthropic-beta: managed-agents-2026-04-01 | OpenAI-Beta: agents=v1 |
| 에이전트 정의 | 별도 리소스 POST /v1/agents, 세션에서 ID로 참조 | 세션에 인라인 agent, 또는 저장된 에이전트 ID |
| 실행 환경 | 별도 리소스 POST /v1/environments (cloud, self_hosted) | 세션에 인라인 environment (none, openai_hosted, self_hosted) |
| 실행 단위 | 세션 POST /v1/sessions, 메시지는 따로 보냄 | 세션 POST /v1/agents/sessions, 생성과 첫 입력을 한 번에 |
| 대화 기록 | 이벤트 /v1/sessions/{id}/events | 항목 /v1/agents/sessions/{id}/items |
| 완료 신호 | session.status_idle 이벤트 | 세션 status와 턴 이벤트 (agent.session.turn.completed 등) |
| 결과 파일 | /mnt/session/outputs/에 쓰면 Files API의 scope_id로 조회 | /workspace/outputs에 쓰면 산출물 API로 조회 |
| 비용 정보 | usage와 list_cost(센트 단위 문자열) | usage(문서상 최선 노력 값, null일 수 있음) |
| 서버 쪽 예산 | 세션 생성 시 max_list_cost | 확인한 문서 페이지에서 찾지 못함 |
| 기본 도구 | agent_toolset_20260401(bash, read, write, edit, glob, grep, web_fetch, web_search) | Codex 하니스 도구 |
| 정리 | 세션과 환경은 DELETE, 에이전트는 아카이브만 가능 | 세션 DELETE, 삭제 뒤에는 산출물도 내려받지 못함 |
차이는 세부 설계에서 나옵니다. Claude는 환경을 재사용할 리소스로 따로 만들게 하고, 세션 생성과 메시지 전송을 나눕니다. OpenAI는 에이전트와 환경을 세션 생성 요청 안에 인라인으로 넣을 수 있고, 첫 입력까지 한 번에 받습니다. 그래서 같은 작업을 시작하는 데 Claude는 에이전트 생성을 포함해 네 번, OpenAI는 한 번 호출했습니다. 에이전트를 재사용하면 Claude 쪽은 세 번입니다. 비용 정보도 다릅니다. Claude는 세션 비용을 list_cost로 바로 주고, OpenAI는 사용량을 최선 노력 값으로만 줍니다.
수렴의 이유는 필자의 해석으로 적습니다. 에이전트를 운영하려는 팀은 제공자와 상관없이 같은 부품을 다시 만들어 왔습니다. 도구 루프, 격리된 실행 환경, 파일을 넣고 꺼내는 길, 중단된 작업을 이어 가는 상태 저장입니다. 두 제공자가 그 공통 부품을 흡수하면서 API의 표면이 그 부품의 모양을 따라가게 된 것으로 보입니다. 두 회사가 모두 자체 호스팅이라는 출구를 남겨 둔 것도 같은 맥락입니다. 실행 환경까지 넘기기 어려운 고객을 위해, 하니스와 상태만 맡고 컴퓨트는 고객 쪽에 두는 선택지입니다.
3. Claude Managed Agents로 첫 세션 돌리기
Managed Agents의 리소스는 네 가지입니다. 에이전트는 모델, 시스템 프롬프트, 도구, MCP 서버, 스킬을 묶은 설정이고, 한 번 만들면 여러 세션에서 ID로 참조합니다. 환경은 샌드박스의 모양을 정하는 설정이고 파일을 담지 않습니다. 세션은 에이전트와 환경을 묶은 실행 한 번이며, 각 세션은 자기 샌드박스를 따로 가집니다. 이벤트는 세션에 오가는 메시지, 도구 호출과 결과, 상태 변화입니다.
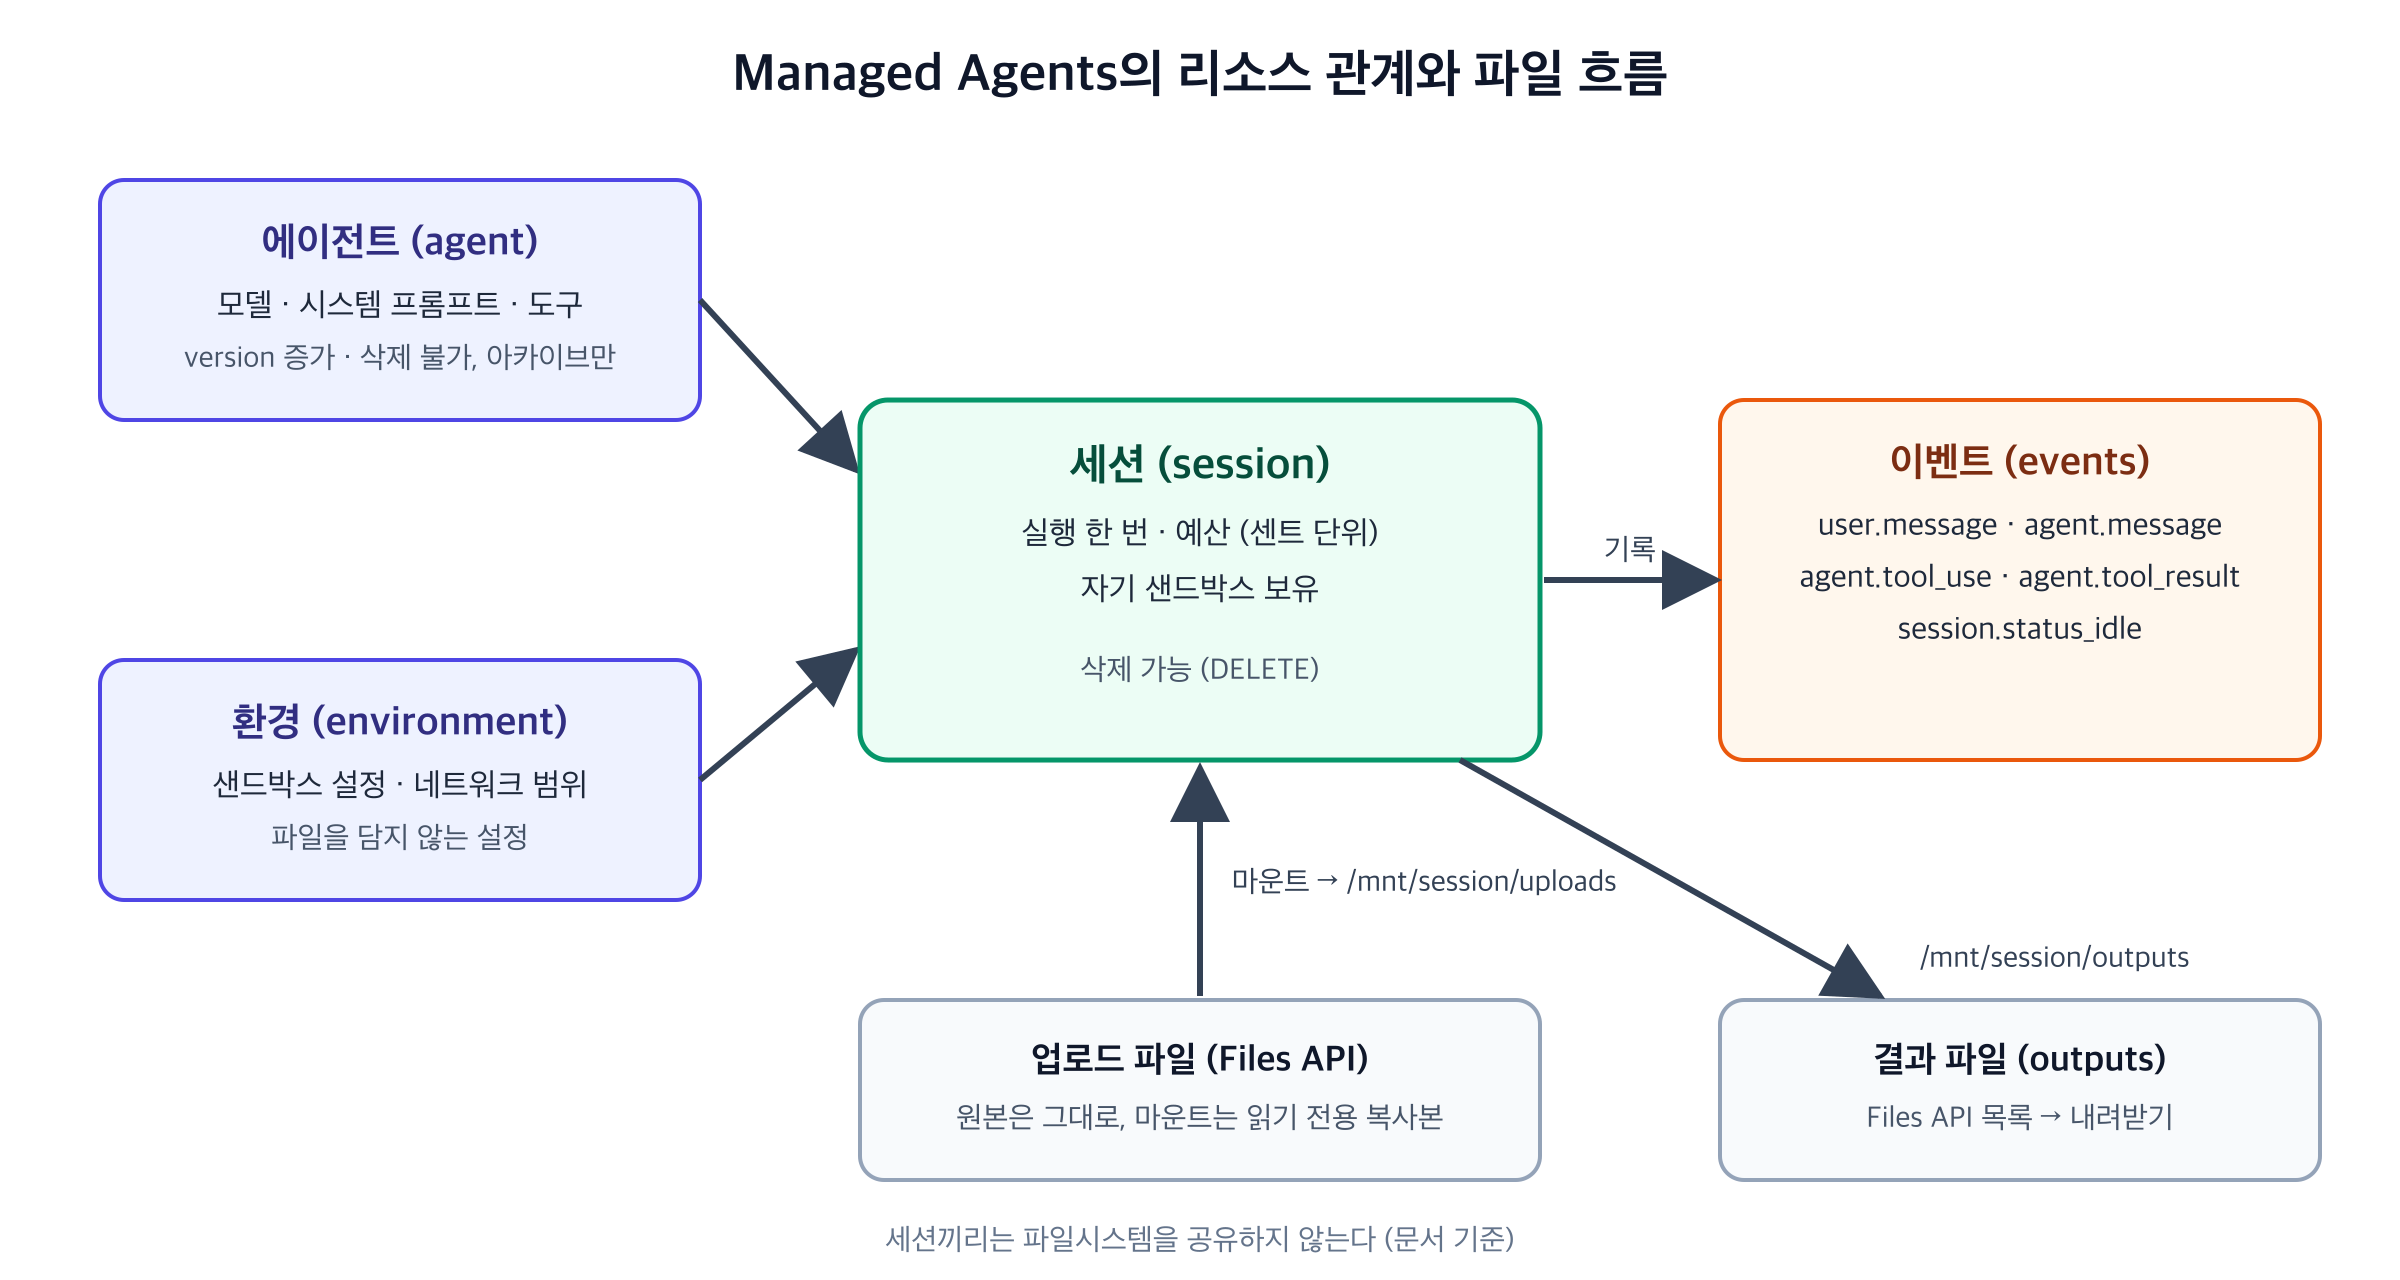
Python SDK로 쓴다면 client.beta.agents가 들어 있는 anthropic 버전이 필요합니다. 0.116.0과 2.1.0에서 beta.agents, beta.sessions, beta.environments가 있는 것을 확인했습니다. 문서에 따르면 Managed Agents는 Claude Platform on AWS에서도 쓸 수 있지만, 기능과 세션 동작에 차이가 있습니다. 아래는 curl로 실행한 여섯 단계입니다.
1단계: 헤더 정의. 요청마다 붙는 인증 헤더와 베타 헤더를 배열 H에 담습니다. 배열은 정의하는 순간 안의 값을 펼치므로, 키를 불러오기 전에 정의하면 빈 키가 고정되어 인증이 실패합니다. 인증 오류가 나면 이 순서부터 확인합니다.
# 키를 불러온 뒤에 정의한다. 배열은 정의하는 순간 값을 펼친다
H=(-H "x-api-key: $ANTHROPIC_API_KEY" -H "anthropic-version: 2023-06-01" \
   -H "anthropic-beta: managed-agents-2026-04-01" -H "content-type: application/json")
anthropic-beta 헤더는 Managed Agents 기능을 켜는 베타 표식입니다. 이 헤더가 없으면 에이전트 API 경로가 열리지 않습니다.
2단계: 에이전트 확보. 이름이 probe인 에이전트를 만들고 그 ID를 AGENT_ID에 저장합니다. 응답의 id만 뽑아 변수에 넣으므로 ID를 손으로 옮기지 않습니다. 에이전트는 지울 수 없으므로, 이 명령은 처음 한 번만 실행합니다.
# 에이전트: 처음 한 번만 만든다. 다시 실행하면 에이전트가 하나 더 생긴다
AGENT_ID=$(curl -sS "${H[@]}" https://api.anthropic.com/v1/agents \
  -d '{"name":"probe","model":"claude-haiku-5-5","tools":[{"type":"agent_toolset_20260401"}]}' | jq -r .id)
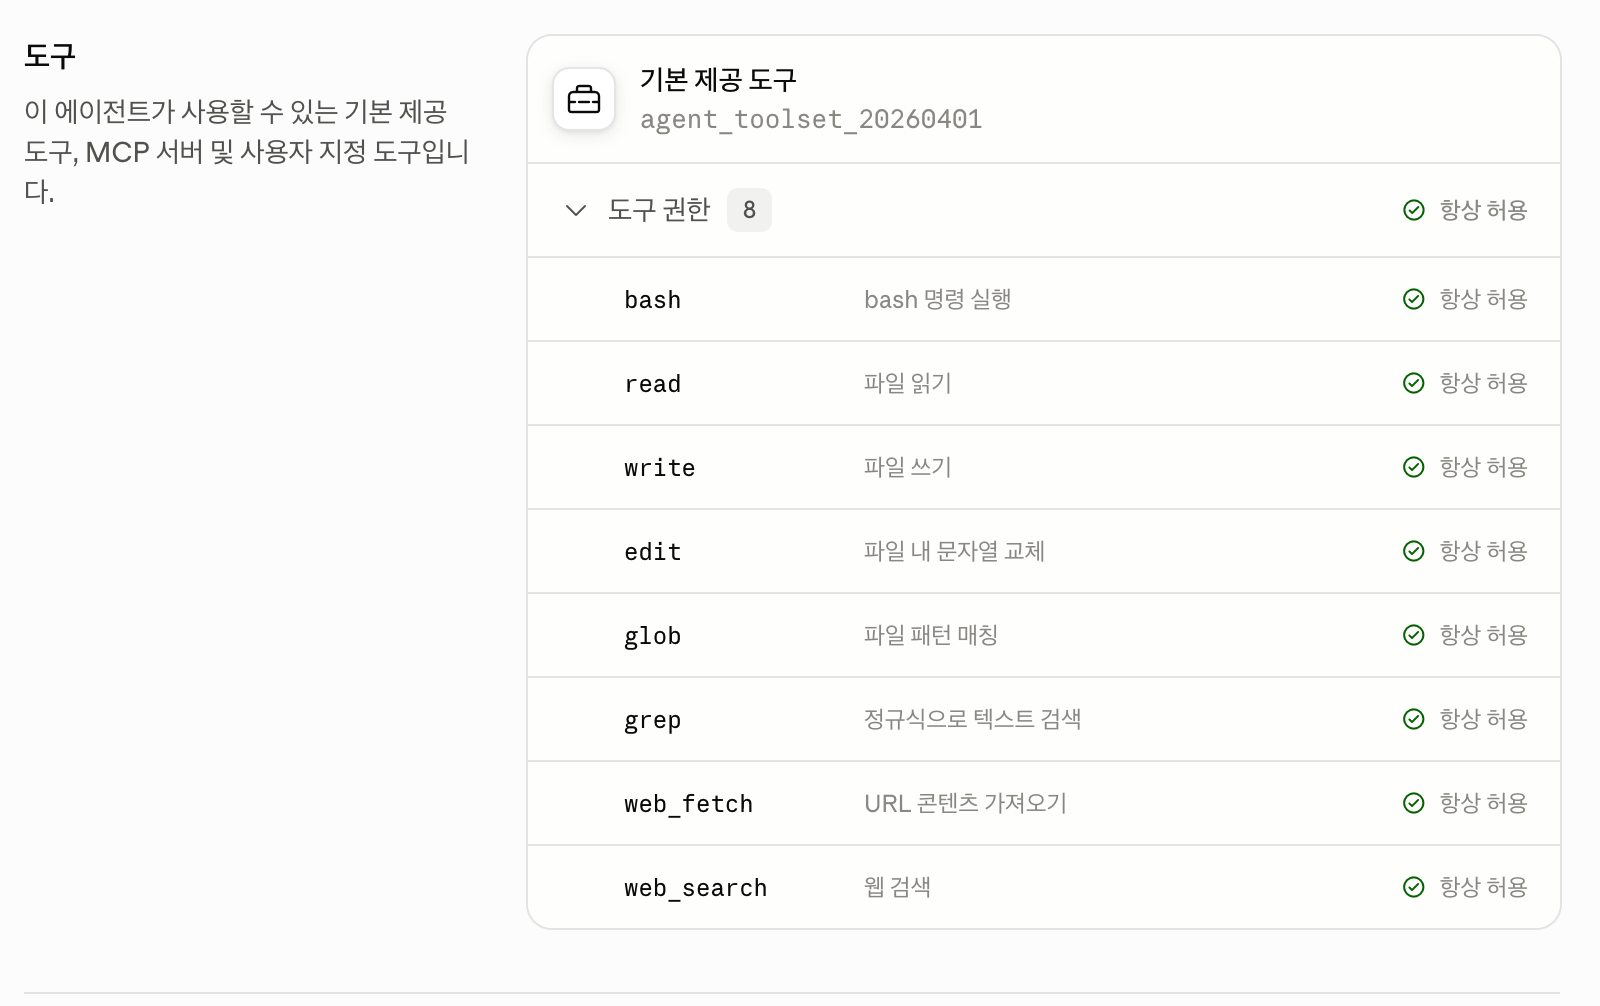
agent_toolset_20260401은 셸, 파일 읽기와 쓰기, 검색, 웹 도구를 한 번에 켜는 도구 묶음입니다. 이 실험의 에이전트가 bash로 스크립트를 쓰고 실행할 수 있었던 이유가 이 설정입니다. 도구마다 permission_policy를 줄 수 있고, 이 묶음의 기본값은 승인 없이 실행하는 always_allow입니다.
Console에서 이 실험의 probe 에이전트를 열면 도구 묶음에 든 도구 여덟 개와 각각의 권한이 보입니다. 여덟 개 모두 "항상 허용"입니다.
3단계: 환경 생성. 샌드박스의 모양을 정하는 환경을 만들고 ENV_ID에 저장합니다. cloud는 Anthropic이 띄우는 샌드박스이고, limited 네트워크는 외부 접근을 허용 목록으로 제한합니다. allow_package_managers를 켜면 패키지 관리자 접근이 열립니다.
# 환경
ENV_ID=$(curl -sS "${H[@]}" https://api.anthropic.com/v1/environments \
  -d '{"name":"probe-env","config":{"type":"cloud","networking":{"type":"limited","allow_package_managers":true}}}' | jq -r .id)
환경은 설정이고 저장 공간이 아닙니다. 같은 환경을 쓰는 세션이라도 파일시스템을 공유하지 않습니다.
4단계: 세션 생성과 예산 설정. 에이전트와 환경을 묶어 세션을 만듭니다. budget은 세션이 쓸 수 있는 비용의 상한입니다. 값은 센트 단위 문자열이라 "50"은 $0.50입니다. jq -n --arg로 JSON을 만들면 따옴표를 직접 이스케이프하지 않아도 됩니다.
# 세션: 예산은 센트 단위 문자열이다. "50"은 $0.50
SESSION_ID=$(jq -n --arg a "$AGENT_ID" --arg e "$ENV_ID" \
  '{agent: $a, environment_id: $e, budget: {type: "limit", max_list_cost: {amount: "50", currency: "USD"}}}' \
  | curl -sS "${H[@]}" https://api.anthropic.com/v1/sessions -d @- | jq -r .id)
예산은 세션을 만들 때만 설정할 수 있습니다. 문서는 상한에 닿으면 새 모델 요청을 멈춘다고 설명하지만, 이 실험에서는 상한에 닿는 상황을 만들지 않았습니다.
5단계: 메시지 전송. 세션의 이벤트 목록에 user.message를 보냅니다. 이 메시지가 작업 지시입니다.
# 메시지 전송
curl -sS "${H[@]}" https://api.anthropic.com/v1/sessions/$SESSION_ID/events \
  -d '{"events":[{"type":"user.message","content":[{"type":"text","text":"피보나치 20개를 fibonacci.txt에 저장하는 스크립트를 작성하고 실행해."}]}]}' | jq .
응답에는 방금 보낸 메시지가 이벤트로 돌아옵니다. 작업이 끝났는지는 이 응답이 아니라 다음 단계에서 확인합니다.
6단계: 완료 대기. session.status_idle 이벤트가 나올 때까지 5초 간격으로 최대 60번, 즉 5분 동안 이벤트 목록을 조회합니다. jq -e는 조건이 참이면 종료 코드 0을 돌려주므로 && break로 반복을 멈출 수 있습니다.
# 완료 대기: session.status_idle 이벤트가 나올 때까지 최대 5분 확인한다
for i in $(seq 1 60); do
  curl -sS "${H[@]}" https://api.anthropic.com/v1/sessions/$SESSION_ID/events \
    | jq -e '.data[] | select(.type=="session.status_idle")' > /dev/null && break
  sleep 5
done
에이전트는 bash 도구로 save_fibonacci.py를 쓰고 실행했습니다. 세션은 idle로 끝났고, 결과 파일 fibonacci.txt(134바이트)가 세션 안에 생겼습니다. 파일에는 0: 0, 1: 1처럼 순번과 값이 한 줄씩 들어 있었습니다. 결과 파일을 받는 방법은 7절에서 다룹니다.
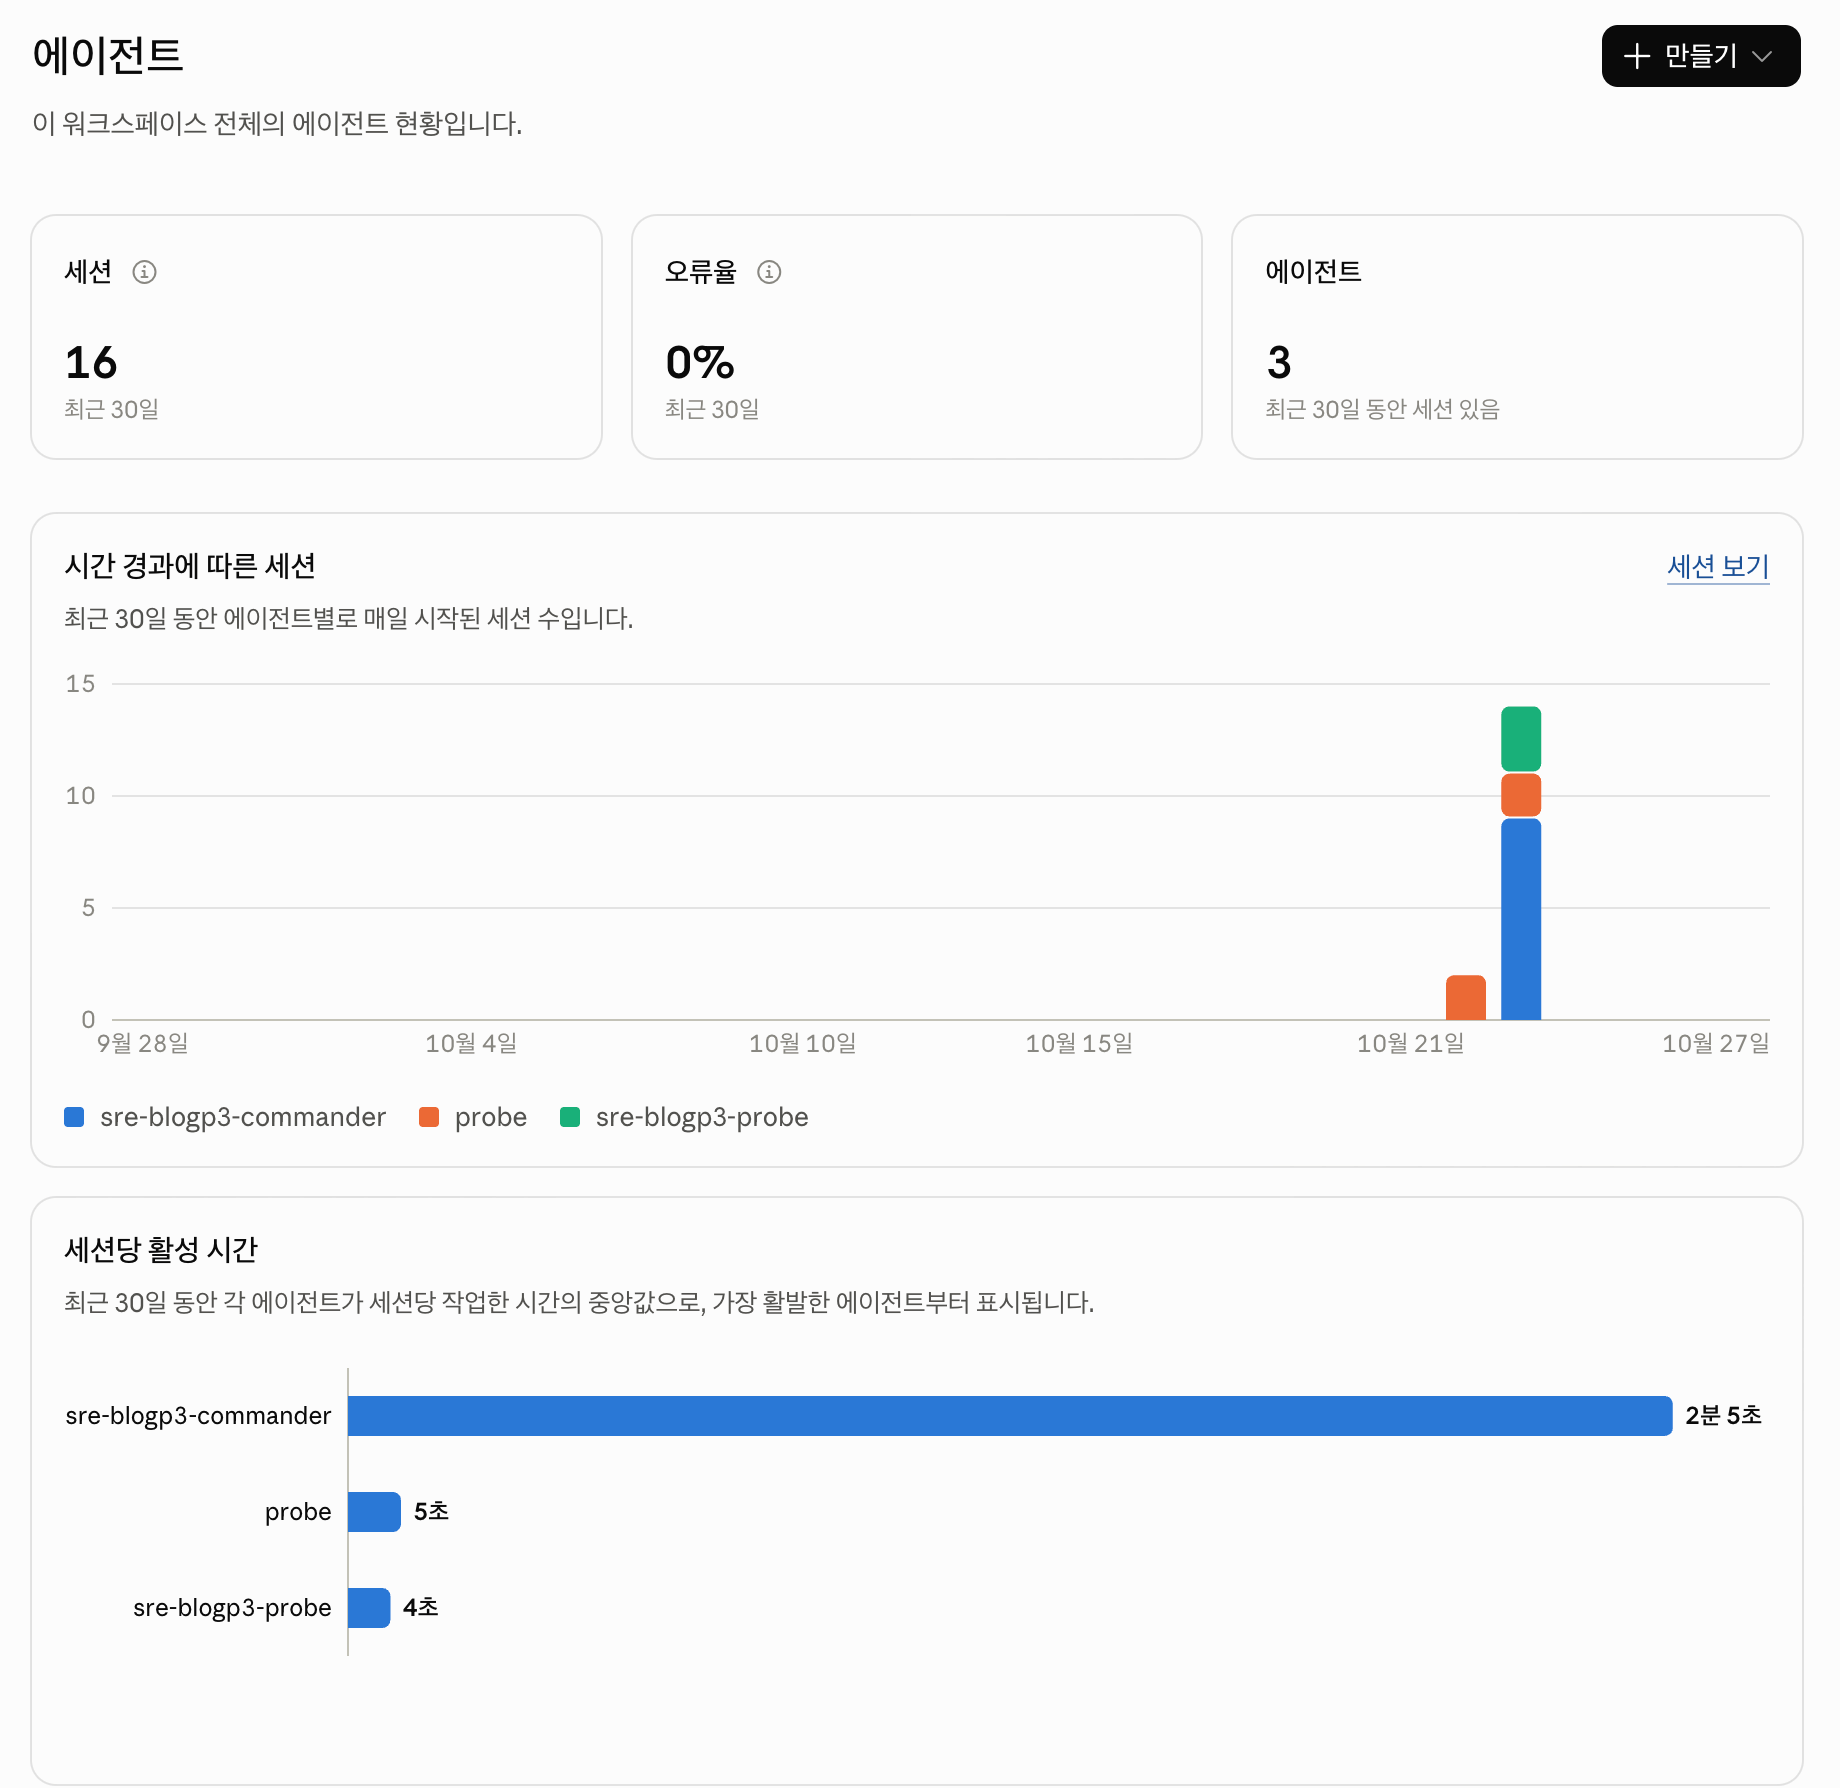
세션은 Console의 에이전트 개요 화면에도 집계됩니다. 아래는 2026-10-27에 본 화면으로, 최근 30일의 세션 수와 오류율, 에이전트별 일일 세션 수, 세션당 활성 시간의 중앙값이 나옵니다. probe가 이 글의 에이전트이고, sre-blogp3-로 시작하는 둘은 3편에서 쓴 에이전트입니다.
4. OpenAI Agents API로 같은 작업 돌리기
같은 피보나치 작업을 OpenAI Agents API에서 돌렸습니다. 모델은 gpt-6-luna, 환경은 OpenAI가 띄우는 openai_hosted 샌드박스의 small 크기입니다.
1단계: 헤더 정의. OpenAI는 Bearer 인증과 OpenAI-Beta: agents=v1 헤더를 씁니다.
OH=(-H "Authorization: Bearer $OPENAI_API_KEY" -H "OpenAI-Beta: agents=v1" -H "content-type: application/json")
베타 헤더를 빼고 보내면 API가 To access the Agents API, set the 'OpenAI-Beta' header to 'agents=v1'.라는 오류로 답합니다. 오류 메시지가 필요한 헤더 이름과 값을 알려 줍니다.
2단계: 세션 생성과 첫 입력. 에이전트 설정, 환경, 첫 입력을 한 요청에 넣습니다. Claude 쪽의 2단계부터 5단계까지가 이 한 번의 호출에 해당합니다.
OSID=$(curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions -d '{
  "agent": {"model": "gpt-6-luna", "instructions": "You are a helpful coding assistant. Write clean, well-documented code."},
  "environment": {"type": "openai_hosted", "container_size": "small"},
  "input": [{"role": "user", "content": [{"type": "input_text",
    "text": "피보나치 20개를 fibonacci.txt에 저장하는 스크립트를 작성하고 실행해. 결과 파일은 /workspace/outputs/fibonacci.txt에 저장해."}]}]
}' | jq -r .id)
응답의 environment에는 기본값이 펼쳐져 돌아왔습니다. 네트워크는 access: enabled에 허용 도메인 목록이 비어 있었고, 데스크톱은 꺼져 있었습니다. 문서, 프레젠테이션, 스프레드시트용 스킬 디렉터리가 capability_directories로 붙어 있었습니다. 따로 정하지 않으면 네트워크가 열린 상태로 시작한다는 뜻이므로, 제한이 필요하면 세션을 만들 때 직접 정해야 합니다.
3단계: 완료 대기. 세션 status가 in_progress에서 벗어나고, 사용자 메시지 말고 다른 항목이 생길 때까지 기다립니다. 상태만 보면 안 되는 이유는 5절에서 설명합니다.
for i in $(seq 1 50); do
  ST=$(curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID | jq -r .status)
  if [ "$ST" != in_progress ]; then
    N=$(curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID/items \
      | jq '[.data[] | select(.type!="message" or .role=="assistant")] | length')
    [ "$N" -gt 0 ] && break
  fi
  sleep 6
done
4단계: 항목 읽기. 세션의 항목(items)에는 메시지 말고도 추론(reasoning)과 명령 실행(command_execution)이 기록됩니다. Claude의 이벤트 목록에 해당합니다.
curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID/items | jq -c '.data[] | {type, role}'
이 실행에서는 사용자 메시지, 어시스턴트 메시지, 추론, 명령 실행 항목이 섞여 나왔습니다. 에이전트는 먼저 작업 계획을 말하고, 명령을 두 번 실행한 뒤, 결과 파일과 스크립트 위치를 알려 주는 메시지로 끝냈습니다.
5단계: 산출물 확인과 내려받기. 턴이 끝나면 /workspace/outputs의 파일이 산출물로 게시됩니다. 목록에서 ID와 경로를 받고, 파일마다 내용을 따로 내려받습니다. 문서는 한 번에 여러 파일을 받는 엔드포인트가 없다고 적습니다.
# 산출물 목록
curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID/artifacts \
  | jq -c '.data[] | {id, path, turn_id, size_bytes}'

# 전부 내려받기
OUT=~/Downloads/openai-$OSID
mkdir -p $OUT
curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID/artifacts \
  | jq -r '.data[] | "\(.id) \(.path | split("/") | last)"' \
  | while read aid name; do
      curl -sS "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID/artifacts/$aid/content -o "$OUT/$name"
    done
ls -l $OUT
산출물은 fibonacci.txt(64바이트)와 generate_fibonacci.py(572바이트) 두 개였고, 둘 다 같은 turn_id를 가졌습니다. 내려받은 fibonacci.txt에는 0부터 4181까지 20개 값이 한 줄에 하나씩 들어 있었습니다.
6단계: 세션 삭제. 삭제 응답은 agent.session.deleted와 deleted: true였고, 이후 세션 조회는 not_found_error를 돌려줬습니다.
curl -sS -X DELETE "${OH[@]}" https://api.openai.com/v1/agents/sessions/$OSID | jq -c '{object, deleted}'
삭제 뒤에 같은 산출물을 다시 내려받으려 하자 404가 났습니다. 문서는 산출물이 샌드박스 만료 뒤에도 남는다고 설명하면서, 보관할 것은 세션을 지우기 전에 받으라고 적습니다. 실제로도 세션 삭제와 함께 산출물에 접근할 수 없게 됐습니다.
같은 작업, 다른 결과물. 두 결과 모두 20개 값이 맞았지만 형식이 달랐습니다. Claude 쪽은 0: 0처럼 순번을 붙여 134바이트, OpenAI 쪽은 값만 적어 64바이트였습니다. 지시문이 형식을 정하지 않으면 모델과 하니스에 따라 결과물이 달라진다는 뜻입니다. 결과물을 다른 프로그램이 읽어야 한다면 형식을 지시문에 적어야 합니다.
5. 턴과 완료 판정
두 API는 "작업이 끝났다"를 판정하는 방식이 다릅니다. 이 차이가 자동화 코드에서 가장 먼저 문제를 일으킵니다.
Claude 쪽 실험에서는 session.status_idle 이벤트가 작업 완료의 신호로 잘 맞았습니다. 이벤트가 나온 시점에 결과 파일이 이미 있었습니다.
OpenAI 쪽에서는 세션 상태만 믿으면 안 된다는 것이 실행으로 드러났습니다. 세션을 만든 직후 상태를 처음 조회했을 때 이미 idle로 보였지만, 그 시점의 항목 목록에는 사용자 메시지 하나뿐이었습니다. 다시 조회하자 상태는 in_progress로 바뀌어 있었고, 어시스턴트 메시지와 명령 실행 항목이 생긴 뒤에야 작업이 끝났습니다. 그래서 위의 대기 루프는 상태와 항목을 함께 봅니다.
OpenAI 문서도 이 점을 경고합니다. 세션이 idle이라고 해서 턴이 성공했다는 뜻은 아니므로, agent.session.turn.completed, agent.session.turn.failed, agent.session.turn.cancelled 중 무엇이 왔는지 확인하라고 적습니다. 완료된 턴이라도 개별 도구 호출이 모두 성공했다는 보장은 없다는 설명도 있습니다.
실행 중에 개입하는 방법은 두 문서 모두 다룹니다. Anthropic 문서는 실행 중인 에이전트에 사용자 이벤트를 더 보내 방향을 바꾸거나 중단할 수 있다고 설명합니다. OpenAI 문서는 진행 중인 턴에 메시지를 보내면 그 턴을 조정하는 steering이 되고, 유휴 세션에 보내면 새 턴이 시작된다고 구분합니다. OpenAI는 재시도용 Idempotency-Key 헤더로 같은 제출을 한 번만 처리하게 하고, 끊긴 스트림의 이벤트는 다시 보내 주지 않으므로 재연결 뒤에는 저장된 항목을 조회해 상태를 복구하라고 안내합니다. 이 개입 기능들은 이 실험에서 실행하지 않았습니다.
6. 사용량과 비용: 하니스에는 고정비가 있다
호스팅 런타임을 쓰면 토큰 외의 비용이 생기고, 토큰 자체도 늘어납니다. 하니스가 매 턴 붙이는 지시문과 도구 정의가 입력에 들어가기 때문입니다.
이 고정비는 실행으로 확인됐습니다. OpenAI의 같은 gpt-6-luna 모델에 짧은 요청을 두 방식으로 보냈습니다. Responses API에 "안녕이라고 한 단어로 답해."를 보냈을 때 입력은 16토큰이었습니다. Agents API 세션(환경 none)에 한 줄짜리 지시문과 "안녕"을 보냈을 때 입력은 7,734토큰이었습니다. 두 요청의 문장이 조금 다르지만, 수천 토큰의 차이는 하니스가 붙이는 맥락에서 온 것으로 보입니다. Claude 쪽도 같은 구조입니다. Claude Agent SDK로 Sonnet 5.5에 짧은 질문 하나를 보냈을 때 캐시 읽기 29,209토큰과 캐시 쓰기 12,310토큰이 잡혔습니다.
Claude: list_cost로 세션 비용을 준다
Claude Managed Agents의 세션 조회는 usage와 list_cost를 함께 줍니다.
curl -sS "${H[@]}" https://api.anthropic.com/v1/sessions/$SESSION_ID | jq '{id, status, usage}'
{
  "status": "idle",
  "usage": {
    "active_seconds": 7.121,
    "cache_creation": { "ephemeral_5m_input_tokens": 7377 },
    "cache_read_input_tokens": 6147,
    "input_tokens": 6,
    "output_tokens": 1159,
    "list_cost": { "amount": "1", "currency": "USD" },
    "server_tool_use": { "web_fetch_requests": 0, "web_search_requests": 0 }
  }
}
input_tokens는 캐시 기준점 뒤에 남은 입력만 셉니다. 전체 입력은 캐시 읽기, 캐시 쓰기, 나머지 입력의 합이고, 이 실행에서는 6 + 6,147 + 7,377 = 13,530토큰입니다. 긴 시스템 프롬프트와 도구 정의는 대부분 캐시를 거치고, 새 메시지만 나머지 입력으로 잡힙니다.
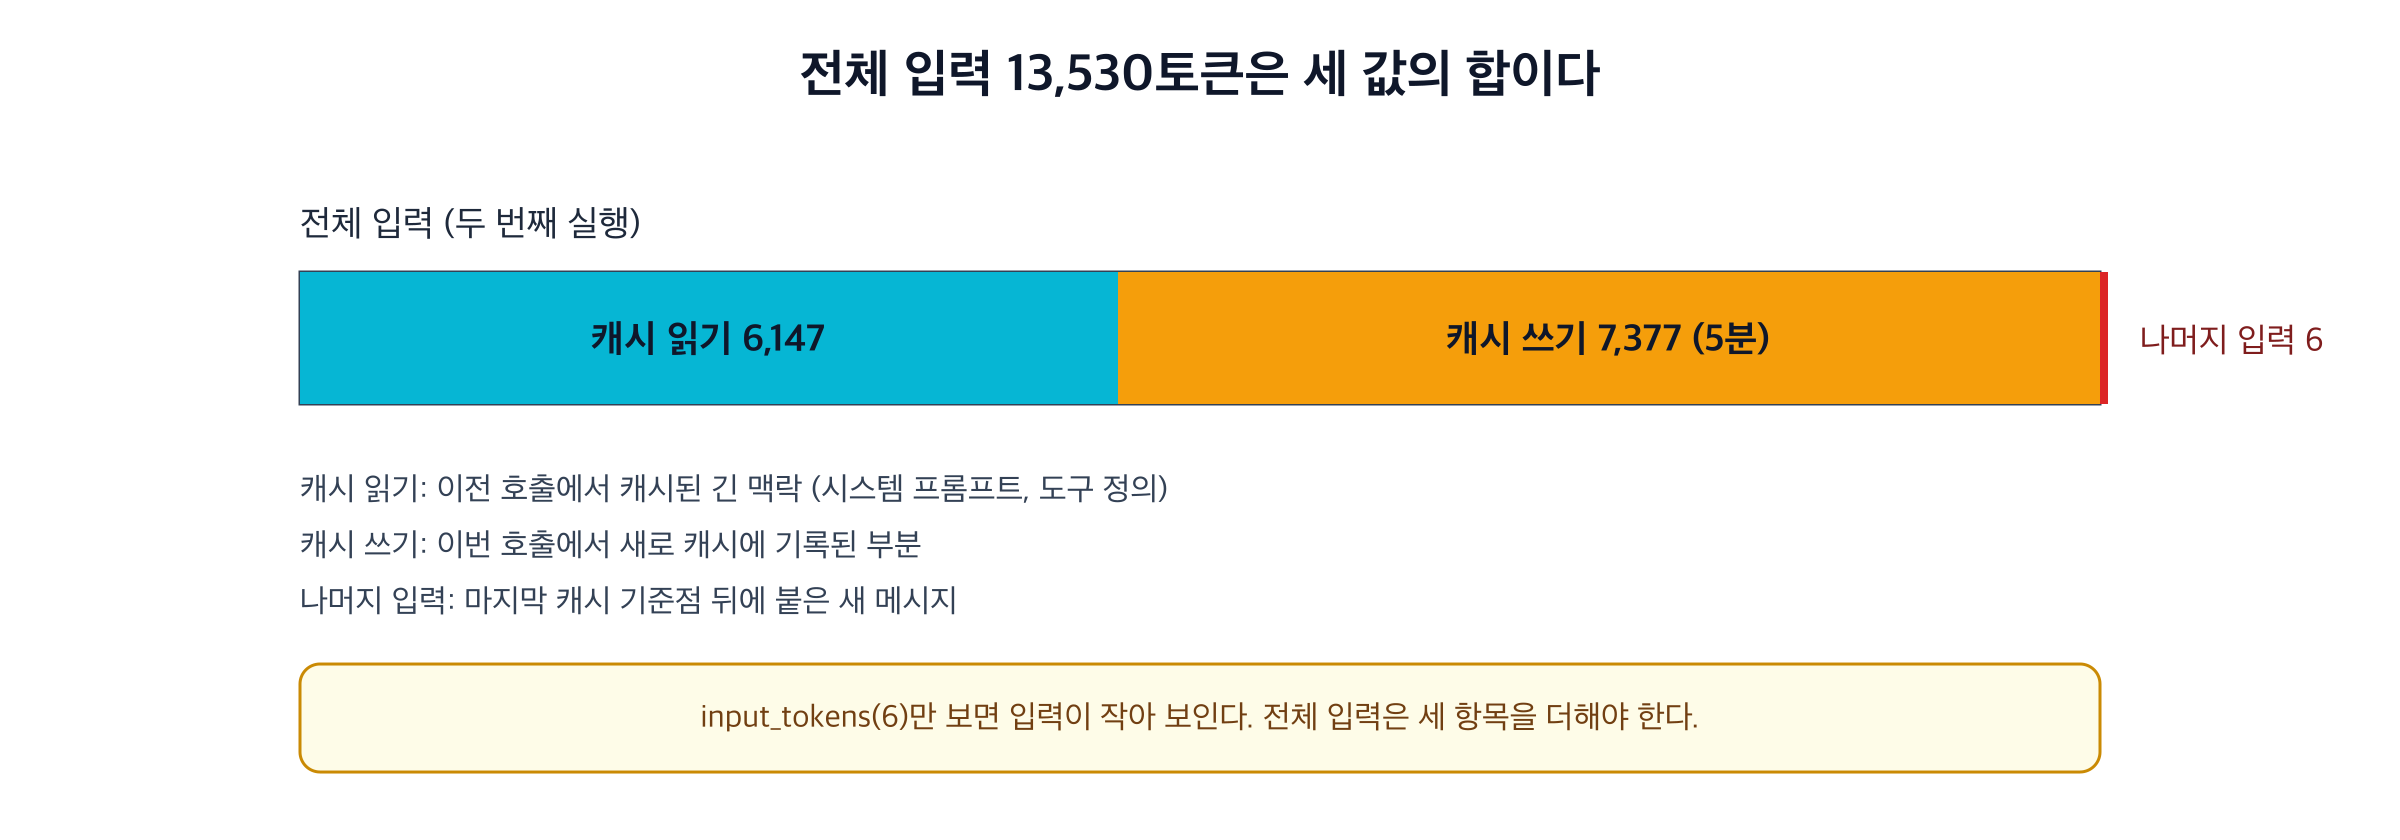
list_cost는 1센트였습니다. 같은 사용량을 Haiku 단가로 계산하면 약 0.16센트이므로, 표시된 값이 토큰 비용보다 큽니다. 센트 단위로 올림한 것인지, 세션 활성 시간에 따른 요금이 따로 붙은 것인지는 공식 문서에서 찾지 못했습니다. 이 글은 이 차이를 확정하지 않습니다.
OpenAI: 사용량은 최선 노력 값이다
OpenAI 문서는 Agents API의 usage를 최선 노력 값이라고 명시합니다. 값이 null일 수 있고, 나중에 바뀔 수 있으며, 최종 청구서가 아니라고 적습니다. 실행 결과도 이와 맞았습니다. 환경 none 세션은 입력과 출력 토큰을 보여 줬지만, 피보나치 세션은 턴이 끝난 뒤에도 usage가 null이었습니다. 문서는 캐시 쓰기 토큰이 Agents API usage에 따로 나오지 않는다고 적는데, Responses API 응답에는 cache_write_tokens 항목이 있었고 값은 0이었습니다.
비용 구성도 다릅니다. OpenAI 가격 페이지 기준으로 호스팅 셸과 코드 인터프리터 컨테이너는 20분 세션 단위로 과금되고, 1GB는 0.12, 16GB는 1.92입니다. 웹 검색은 1,000회당 $10에 검색 내용 토큰이 모델 요금으로 더해집니다. Claude 쪽에서는 웹 검색 한 번이 약 $0.01로 측정됐지만, 공식 단가로 확인한 값은 아닙니다. Claude 세션의 활성 시간 단가도 공식 문서에서 찾지 못했습니다.
숨은 호출과 스트림 값
Claude Agent SDK에서 웹 검색을 실행하면, 검색 한 번마다 CLI가 내부에서 Haiku를 한 번 더 호출했습니다. 그 입력은 약 14K토큰이었고, 이 호출은 메시지 스트림에 나오지 않고 모델별 합계(model_usage)에만 잡혔습니다. 메시지 단위 합계만 보면 비용이 크게 과소 계산됩니다.
스트림 조각의 값도 주의해야 합니다. 같은 message_id의 조각마다 usage가 오지만 조각의 값은 시작 시점에 머물렀습니다. 한 메시지의 조각은 출력 4토큰이었고, 최종 값은 4,579토큰이었습니다. 하니스를 제공자가 맡을수록 계측의 단위도 제공자가 정합니다. 합계가 서로 맞는지 확인하기 전에는 어떤 계측 값도 비용의 근거로 쓰지 않는 편이 맞습니다.
7. 파일과 샌드박스
파일은 두 API 모두 정해진 디렉터리를 통해 드나듭니다.
Claude Managed Agents에서는 Files API로 올린 파일을 세션 생성 시 resources의 file 항목으로 마운트합니다. 마운트된 파일은 읽기 전용 복사본이라, 수정본은 샌드박스의 다른 경로에 씁니다. 에이전트가 /mnt/session/outputs/에 쓴 파일은 세션 범위로 Files API에 나타납니다.
# 세션의 출력 파일 목록
curl -sS "${H[@]}" "https://api.anthropic.com/v1/files?scope_id=$SESSION_ID" | jq -c '.data[] | {id, filename, size_bytes}'

# 전부 내려받기
OUT=~/Downloads/managed-$SESSION_ID
mkdir -p $OUT
curl -sS "${H[@]}" "https://api.anthropic.com/v1/files?scope_id=$SESSION_ID" \
  | jq -r '.data[] | "\(.id) \(.filename)"' \
  | while read id name; do
      curl -sS "${H[@]}" "https://api.anthropic.com/v1/files/$id/content" -o "$OUT/$name"
    done
ls -l $OUT
이 실행에서 fibonacci.txt와 save_fibonacci.py(1,025바이트)가 목록에 바로 나타났습니다. 문서는 방금 쓴 파일이 목록에 늦게 나타날 수 있다고 안내합니다. 한도는 파일당 500MB, 조직 전체 1TB, 세션당 마운트 500개입니다. 세션을 지운 뒤 파일이 남는지는 확인하지 못했습니다.
OpenAI Agents API는 한도를 더 잘게 문서화합니다. 세션 생성 요청에 함께 넣는 파일은 50개까지, 인라인 업로드는 파일당 5MiB와 요청당 합계 10MiB, Files API에서 복사하는 파일은 파일당 50MiB입니다. 산출물은 파일당 200MiB, 한 번에 게시되는 합계 500MiB까지입니다. 산출물은 턴 단위로 게시되고 수정할 수 없으므로, 새 버전이 필요하면 에이전트에게 다시 쓰게 하고 턴 ID와 경로로 버전을 구분합니다.
샌드박스의 수명은 OpenAI 쪽이 더 명시적입니다. 호스팅 샌드박스는 연결된 동안 keep-alive를 받고, 활동과 keep-alive가 한 시간 멈추면 삭제될 수 있습니다. 이 시간 제한은 설정할 수 없습니다. 세션을 지우면 샌드박스 정리가 요청되고, 정리가 진행 중이면 409가 올 수 있습니다. 컨테이너 크기는 small(1 vCPU, 1GB), medium(2 vCPU, 4GB, 기본값), large(4 vCPU, 16GB)로 고릅니다.
실행 환경을 누가 운영하는가
두 회사가 모두 자체 호스팅을 제공하지만, 운영 책임이 고객에게 넘어온다는 점도 같습니다.
- Claude Managed Agents의
self_hosted환경에서는 내 인프라의 워커 프로세스가 도구를 실행합니다. 워커 호스트는 Linux여야 하고, API 키를 그 호스트에 두지 않는 것이 권장됩니다. 커스텀 도구는 SDK 워커에서만 지원됩니다. - OpenAI의
self_hosted환경에서는 내가 컴퓨트를 띄우고 실행기를 세션에 연결합니다. 프로비저닝, 재연결, 종료, 보존할 파일이 모두 내 책임입니다. 문서는 세션을 삭제해도 환경이 멈추지 않고 삭제 웹훅도 나오지 않는다고 명시합니다.
자체 호스팅에서는 "세션 삭제"와 "컴퓨트 종료"가 서로 다른 동작입니다. 세션만 지우면 컴퓨트 비용이 계속 나갈 수 있습니다.
OpenAI Agents SDK는 샌드박스를 애플리케이션 쪽 층으로 다룹니다. SandboxAgent는 일반 에이전트와 같은 표면을 가지면서 실행 경계만 라이브 샌드박스로 바꿉니다. 작업 공간의 초기 상태는 Manifest로 정의하고, 실행 위치는 Unix 로컬, Docker, 호스팅 제공자 중에서 샌드박스 클라이언트로 고릅니다. 문서는 하니스를 애플리케이션에 두고 컴퓨트만 샌드박스에 두라고 권합니다. 호스팅 런타임 API와 정반대의 분할입니다.
8. 리소스의 수명과 정리
Claude 쪽 리소스는 삭제 방식이 서로 다릅니다. 아래는 실험으로 확인한 것입니다.
| 리소스 | 삭제 | 그 밖의 동작 |
|---|---|---|
| 세션 | DELETE로 삭제됨 | 응답 session_deleted |
| 환경 | DELETE로 삭제됨 | 응답 environment_deleted |
| 에이전트 | DELETE는 not_found | POST .../archive로 아카이브, 되돌릴 수 없음 |
아카이브된 에이전트는 기본 목록(GET /v1/agents)에서 빠지고, ?include_archived=true를 붙이면 다시 나옵니다. 이 동작은 문서에 없고 관찰한 결과입니다. 에이전트 이름은 업데이트 API로 바꿀 수 있었고, 바꿀 때 버전이 1에서 2로 올랐습니다.
Console의 에이전트 목록도 같은 방식으로 보여 줍니다. 상태 필터의 기본값인 "활성"에서는 아카이브한 에이전트가 하나도 나오지 않고, "전체"로 바꾸면 "보관됨" 표시와 함께 나옵니다.
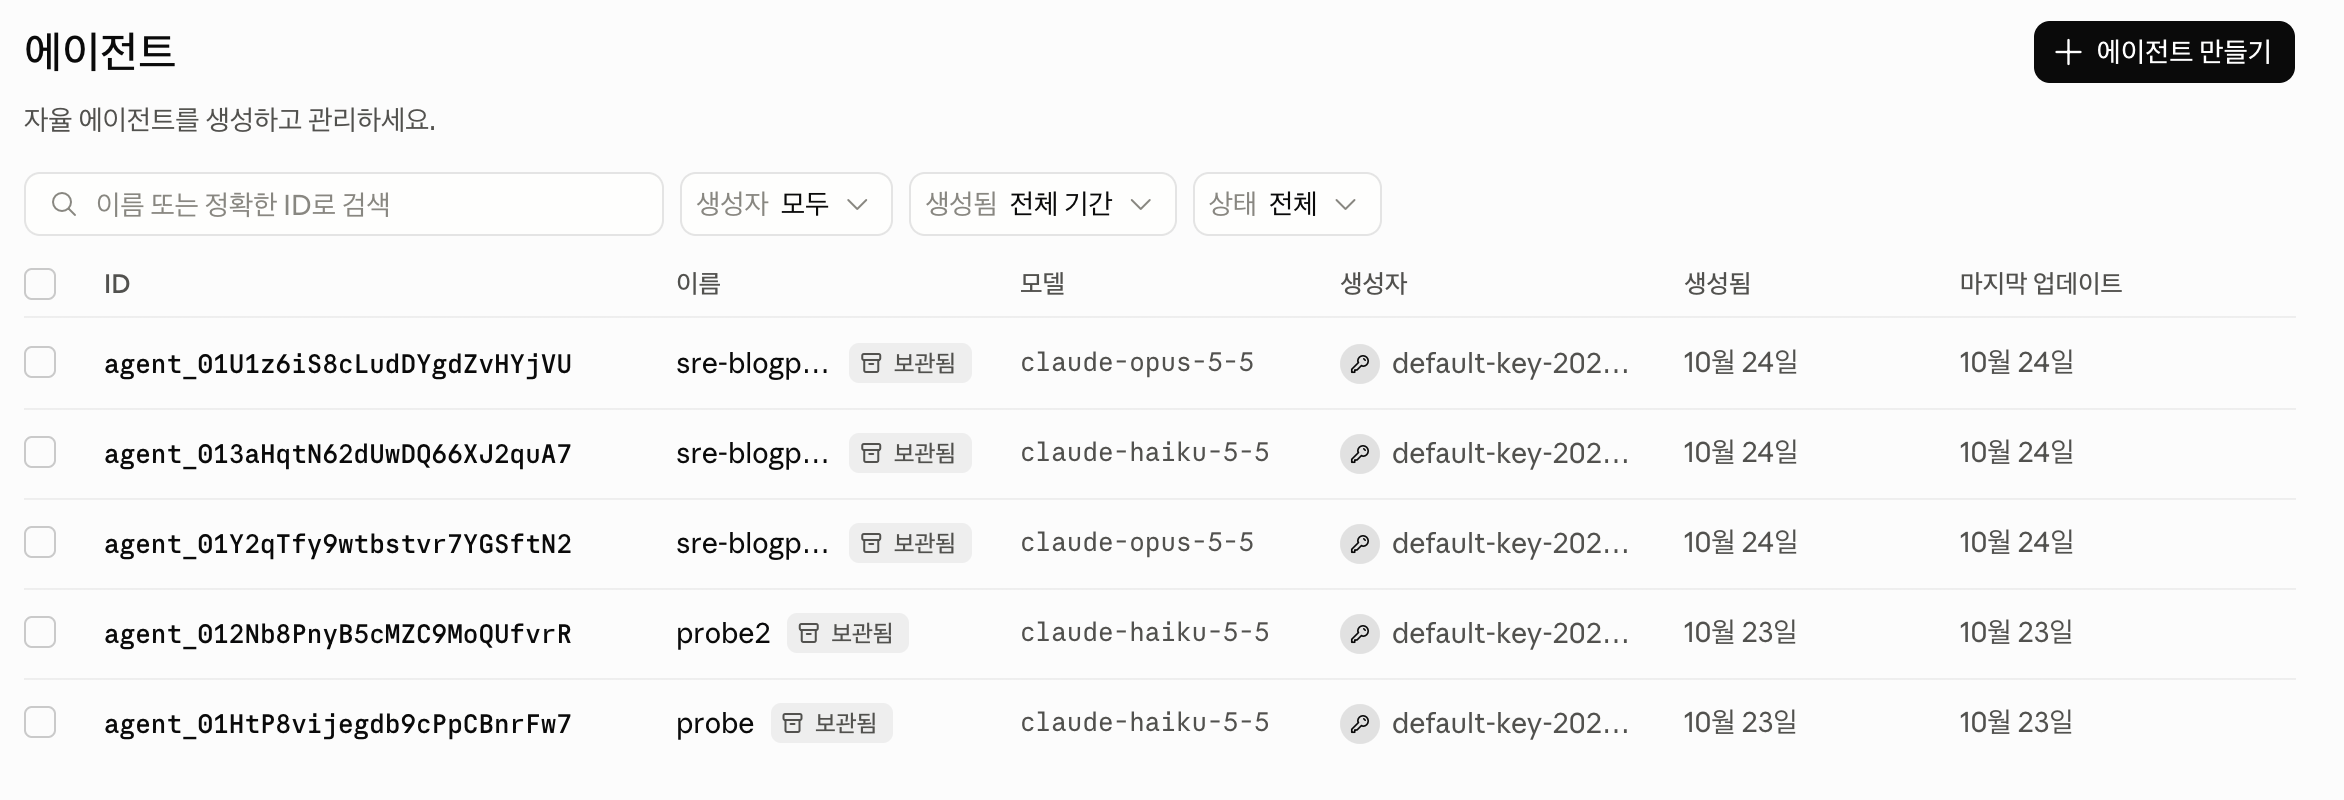
# 목록 확인: archived_at이 null이면 아카이브되지 않은 에이전트다
curl -sS "${H[@]}" https://api.anthropic.com/v1/agents | jq -c '.data[] | {id, name, version, archived_at}'

# 아카이브 (되돌릴 수 없다). AGENT_ID가 agent_로 시작할 때만 실행한다
[[ "$AGENT_ID" == agent_* ]] && curl -sS -X POST "${H[@]}" https://api.anthropic.com/v1/agents/$AGENT_ID/archive | jq '{id, name, archived_at}'
에이전트를 지울 수 없다는 점은 설계에 영향을 줍니다. 비슷한 이름의 에이전트가 쌓이면 이름으로 찾는 코드가 모호해집니다. 에이전트는 만들기 전에 이름과 개수를 정해 두는 편이 맞습니다. OpenAI 쪽은 에이전트를 세션 요청에 인라인으로 넣으면 따로 남는 에이전트 리소스가 없습니다. 세션을 지우면 정리가 끝나지만, 4절에서 본 것처럼 산출물도 함께 내려받을 수 없게 됩니다.
9. 설정은 어디에 사는가
호스팅 런타임 API가 만든 가장 큰 변화는 설정이 사는 곳입니다. 로컬 하니스에서 설정은 파일과 코드에 있고, 호스팅 런타임에서는 제공자 서버의 리소스에 있습니다.
claude -p의 설정은 셸과 파일에 흩어져 있습니다. 명령줄 플래그, 프로젝트 설정 파일, 현재 디렉터리의 지시 파일이 함께 작동하고, 대화는 --resume과 세션 ID로 이어 갑니다. Claude Agent SDK의 설정은 코드 안의 ClaudeAgentOptions 객체입니다. 모델, 허용 도구, MCP 서버, 턴 상한, 예산, 사고 설정을 담고, @tool로 파이썬 함수를 도구로 붙입니다.
import asyncio
from claude_agent_sdk import AssistantMessage, ClaudeAgentOptions, ResultMessage, TextBlock, query

async def main():
    options = ClaudeAgentOptions(model="claude-haiku-5-5", tools=[], max_turns=1)
    async for message in query(prompt="안녕이라고 한 단어로 답해.", options=options):
        if isinstance(message, AssistantMessage):
            for block in message.content:
                if isinstance(block, TextBlock):
                    print(block.text)
        elif isinstance(message, ResultMessage):
            print("비용(SDK 보고):", message.total_cost_usd)

asyncio.run(main())
OpenAI Agents SDK의 설정도 애플리케이션 코드의 객체입니다. 대신 대화 상태를 어디에 둘지 네 가지 중에서 고릅니다. 앱이 이전 기록을 직접 넘기거나, 앱 저장소와 SDK 세션을 쓰거나, 서버의 Conversations 객체를 쓰거나, 이전 응답의 ID를 이어받습니다. 문서는 한 대화에 한 방식만 쓰라고 권합니다. 로컬 재생과 서버 상태를 섞으면 맥락이 중복되기 때문입니다.
호스팅 런타임에서는 설정이 서버 리소스이므로, "바뀐 설정이 어느 실행에 적용되는가"가 새 질문이 됩니다. OpenAI 문서는 이 규칙을 명시합니다. 저장된 에이전트를 바꾸면 그 변경은 새 세션에만 적용되고, 세션은 생성 시점의 설정을 복사해 가집니다. 기존 세션에서 바꿀 수 있는 항목은 모델, 추론 강도, 서비스 등급뿐이고, 지시문과 도구는 새 세션을 만들어야 바뀝니다. 부분 갱신에서는 생략한 필드가 유지되지만 객체 필드는 통째로 교체됩니다. reasoning에 effort만 주면 저장돼 있던 summary가 지워지고, tools 배열을 주면 기존 목록 전체가 바뀝니다.
Claude Managed Agents에서는 이름 변경이 업데이트 API로 되고 버전이 올라가는 것까지 확인했습니다. 부분 갱신 규칙과, 실행 중인 세션이 설정을 복사해 가지는지는 확인하지 못했습니다. 이 부분에서 두 제품이 같다고 말할 근거는 아직 없습니다.
10. 같은 런타임의 사람용 출구: Claude Code 클라우드와 Codex Cloud
호스팅 런타임은 API로만 나온 것이 아닙니다. 두 회사는 같은 층을 사람이 쓰는 화면으로도 내놓았습니다. Claude Code 클라우드 세션(claude.ai/code, claude --cloud)과 Codex Cloud입니다. 이 둘은 개발자가 웹, 모바일, 데스크톱에서 과제를 맡기고 이어 가는 제품입니다. 1절의 표로 보면 네 번째 층, 화면까지 제공자가 맡는 층입니다.
| 축 | Claude Code 클라우드 세션 | Codex Cloud | Managed Agents | OpenAI Agents API |
|---|---|---|---|---|
| 조작하는 쪽 | 사람 (웹, 모바일, 데스크톱, 터미널) | 사람 (웹, 모바일, 데스크톱, CLI) | 프로그램 | 프로그램 |
| 작업 단위 | 세션 | 과제(task), 과제마다 독립 작업공간 | 세션과 이벤트 | 세션과 턴 |
| 재사용 설정 | 저장소의 CLAUDE.md, hooks, skills, agents, commands | 환경(저장소, 도구, 서비스 접근) | 에이전트와 환경 리소스 | 저장된 에이전트, 인라인 설정 |
| 설정 변경의 반영 | 문서에서 찾지 못함 | 환경을 수정하고 재발행해야 새 과제에 반영, 기존 과제는 자기 상태 유지 | 확인하지 못함 | 새 세션에만 반영 |
| 시작 자료 | GitHub 저장소 클론, 로컬 저장소 번들 | 발행된 환경의 준비된 파일시스템 | 저장소 마운트, 업로드 파일 | 업로드 파일 |
| 실행 위치 | Anthropic 관리 VM (Ubuntu 24.04) | OpenAI 관리 VM | Anthropic 샌드박스 또는 자체 호스팅 | OpenAI 샌드박스, 자체 호스팅, 또는 샌드박스 없음 |
| 로컬과의 연결 | --teleport로 클라우드 세션을 터미널로 가져옴(한 방향) | 모바일에서 연결된 Mac이나 Windows PC의 과제를 조작 | 자체 호스팅 워커 | 자체 호스팅 실행기 |
| 상태 보존 | 문서에서 찾지 못함 | 과제 VM 상태를 마지막 턴 뒤 최대 7일 복구 | 세션 기록은 서버에 남음, 샌드박스 보존은 확인하지 못함 | 1시간 무활동이면 샌드박스 삭제 가능, 산출물은 세션 삭제 전까지 |
| 과금 | 구독 사용 한도 (API 크레딧 미적용) | ChatGPT 플랜 (사용량 단위는 찾지 못함) | API 토큰, 세션 활성 시간, 웹 검색 | API 토큰, 컨테이너, 웹 검색 |
| 서버 쪽 예산 | 없음 | 찾지 못함 | max_list_cost | 찾지 못함 |
두 클라우드 코딩 제품의 설정 단위는 저장소와 환경입니다. Claude Code 클라우드는 저장소에 들어 있는 Claude Code 설정을 그대로 읽고, 내 컴퓨터의 ~/.claude 설정은 쓰지 않습니다. Codex Cloud는 저장소, 의존성, 도구, 서비스 접근을 묶은 환경을 준비하고 테스트한 뒤 발행하게 합니다. 과제를 시작할 때마다 그 발행본에서 독립 작업공간이 만들어지고, 과제 안에서 바뀐 파일은 환경에 반영되지 않습니다. 저장소에 있는 스킬은 클라우드 과제에서도 쓰이지만, 내 컴퓨터의 개인 스킬은 동기화되지 않습니다.
네트워크와 비밀값을 다루는 방식은 Codex Cloud 문서가 자세합니다. 현재 문서는 환경 설정에서 인터넷 접근을 켜고, 패키지 관리자 프리셋이나 직접 지정한 도메인으로 범위를 정하는 절차로 설명합니다. 비밀값은 두 종류로 나뉩니다. 프로그램이 직접 읽는 환경 변수와, 특정 HTTPS 목적지에만 보내는 네트워크 시크릿입니다. 네트워크 시크릿은 프로그램에 자리표시자만 보이고, 허용된 목적지로 나갈 때 프록시가 실제 값으로 바꿉니다. 같은 수준의 규칙을 Claude Code 클라우드 문서에서는 찾지 못해서 이 항목은 비교하지 못했습니다.
Codex는 실행 위치를 한 화면에서 고르게 합니다. 데스크톱 앱에서 과제를 시작할 때 "이 컴퓨터"와 "클라우드"를 고르고, 로컬 Git 프로젝트라면 워크트리로 변경을 격리할 수 있습니다. 모바일 앱은 클라우드 과제뿐 아니라 연결된 PC에서 도는 과제도 조작하고, 명령 승인과 변경 검토를 폰에서 합니다. 클라우드 과제는 클라우드 환경에 있는 파일과 서비스만 쓰며, 내 컴퓨터의 로컬 파일, 실행 중인 프로세스, 브라우저 로그인, VPN 접근은 자동으로 넘어가지 않습니다.
이 표를 1절의 맥락에서 읽으면, 두 회사는 같은 호스팅 런타임을 두 개의 출구로 내놓은 셈입니다. 사람에게는 화면과 저장소 중심의 설정으로, 프로그램에게는 리소스와 계측 중심의 API로 내놓았습니다. OpenAI가 Agents API를 "Codex 하니스"라고 부르는 것은 이 연결을 공식적으로 인정한 것입니다. 다만 Codex Cloud와 Agents API가 같은 인프라를 공유하는지, Claude Code 클라우드와 Managed Agents가 같은 하니스인지는 이 글에서 확인하지 못했습니다. 두 클라우드 코딩 제품은 실행하지 않았고, 표는 문서 기준입니다.
11. 통제 수단
호스팅 런타임에서 실행을 통제하는 수단은 권한, 네트워크, 예산, 비밀값입니다. 제공자가 실행을 맡는 만큼, 이 통제도 설정 항목으로 넘어옵니다.
Claude Managed Agents는 도구별 permission_policy로 승인을 정합니다. always_allow는 자동 실행이고, always_ask는 세션을 멈추고 승인을 기다립니다. 에이전트 도구 묶음의 기본값은 always_allow, MCP 도구의 기본값은 always_ask입니다. 네트워크는 환경의 networking.type으로 정하고, 예산은 세션의 max_list_cost로 겁니다.
OpenAI Agents API에서는 세션 예산이나 지출 상한 항목을 확인한 문서 페이지에서 찾지 못했습니다. 네트워크는 샌드박스 설정에서 enabled, disabled, restricted(허용 도메인만) 중 하나로 정하고, 실제 호출에서는 따로 정하지 않았을 때 enabled로 시작했습니다. 비밀값은 vault 자격 증명으로 샌드박스 밖에 두고, PATH, CODEX_*, OPENAI_API_KEY 같은 예약 이름은 환경 변수로 넣을 수 없습니다.
OpenAI Agents SDK는 승인을 앱의 흐름으로 다룹니다. 실행이 승인을 기다리며 멈추면 interruptions를 처리하고 저장된 state에서 재개합니다. 새 사용자 턴을 시작하는 것이 아니라 멈춘 실행을 이어 가는 방식입니다.
로컬 하니스 쪽에서는 claude -p가 구독 한도 안에서 돌기 때문에 서버 쪽 예산 상한이 없고, 허용 도구와 권한 모드로 실행을 제한합니다. 같은 명령이라도 인증 수단에 따라 과금 장부가 바뀝니다. 이 점은 1편에서 다뤘습니다. Claude Agent SDK는 max_budget_usd를 받지만, 웹 검색을 쓰는 에이전트 두 개에 각각 1을 넘었습니다(1.20). 상한이 언제 검사되는지 확인하지 못했으므로, 이 값을 비용 보증으로 믿으면 안 됩니다.
정리하면, 서버가 예산을 강제한다고 문서에 명시한 것은 이 글에서 다룬 제품 가운데 Claude Managed Agents뿐입니다. 그 강제가 실제로 작동하는지는 확인하지 않았습니다.
12. 이 층이 생기면서 달라지는 것
호스팅 런타임 API가 생기면서 개발자가 얻는 것과 넘겨주는 것이 분명해졌습니다. 아래는 이 글의 실행 결과와 문서를 바탕으로 한 필자의 해석입니다.
얻는 것. 에이전트를 돌릴 기계가 필요 없어집니다. 노트북이 잠들어도 세션은 제공자 쪽에서 이어집니다. 격리된 실행 환경, 파일을 넣고 꺼내는 길, 중단된 작업을 이어 갈 상태 저장을 직접 만들지 않아도 됩니다. 웹훅과 예약 실행이 같은 API 체계 안에 있어서, 외부 이벤트나 정해진 시간에 세션을 여는 일이 쉬워집니다. Claude 쪽에서는 서버가 강제하는 세션 예산도 생깁니다.
넘겨주는 것. 첫째, 로컬의 맥락입니다. 샌드박스는 내 파일 시스템이 아니고, 내 컴퓨터의 설정, 로그인, VPN도 넘어가지 않습니다. 둘째, 계측의 주도권입니다. 하니스가 붙이는 고정 입력, 숨은 내부 호출, 반올림 기준, 최선 노력 사용량처럼 비용을 결정하는 요소를 제공자가 정합니다. 셋째, 이식성입니다. 에이전트, 환경, 세션은 제공자마다 다른 리소스이고, Claude의 에이전트는 지울 수도 없습니다. 넷째, 데이터의 위치입니다. 세션 기록과 샌드박스 상태가 제공자 서버에 남습니다. Anthropic 문서는 Managed Agents가 ZDR과 HIPAA BAA 대상이 아니라고 적습니다.
두 회사가 같은 추상화로 수렴했다는 점은 이식성 문제를 조금 덜어 줍니다. 에이전트, 환경, 세션, 이벤트라는 뼈대가 같으므로, 한쪽에서 짠 운영 코드를 다른 쪽으로 옮길 때 바꿔야 할 것은 대부분 이름과 경로입니다. 다만 완료 판정, 사용량의 신뢰도, 산출물의 수명처럼 두 API를 실행했을 때 실제로 달랐던 동작은 옮길 때마다 다시 확인해야 합니다.
13. 무엇을 고를까
아래 기준도 필자의 해석이며 확정된 권고가 아닙니다.
- 내 컴퓨터의 파일과 저장소를 직접 다뤄야 한다면
claude -p, Claude Agent SDK, Codex의 로컬 실행이 맞습니다. 호스팅 샌드박스는 내 파일 시스템이 아닙니다. 자체 호스팅으로 로컬 자원을 쓰는 길도 있지만, 운영 책임이 내게 넘어옵니다. - 루프와 승인과 상태 저장을 앱 안에서 세밀하게 제어하고 싶다면 Claude Agent SDK나 OpenAI Agents SDK가 맞습니다.
- 사람이 웹이나 모바일에서 코딩 과제를 맡기고 이어 가려면 Claude Code 클라우드나 Codex Cloud가 맞습니다. 저장소 설정을 그대로 쓰고, 구독이나 플랜 안에서 돕니다.
- 프로그램이 세션을 열고, 기계 없이 오래 돌고, 결과를 파일로 받아야 한다면 Managed Agents나 OpenAI Agents API가 맞습니다. 외부 이벤트로 세션을 열 때도 이쪽이지만, 이벤트를 받는 수신부는 직접 만들어야 합니다.
- 서버가 예산을 강제해야 한다면 이 글에서 다룬 제품 가운데 문서로 확인된 것은 Managed Agents의 세션 예산뿐입니다.
- 대화형으로 코드를 고치는 작업이라면 호스팅 런타임 API는 맞지 않습니다. 로컬 하니스나 클라우드 코딩 제품이 낫습니다.
어느 쪽을 고르든, 호스팅 런타임에서 가장 자주 틀리는 판단은 비용입니다. 하니스의 고정 입력, 웹 검색에 딸린 내부 호출, 컨테이너와 세션 시간 요금이 토큰 계산 밖에 있습니다. 실행 뒤에 사용량 객체와 모델별 합계를 함께 보고, 서로 맞는지부터 확인하는 습관이 필요합니다.
참고 자료
- Claude Managed Agents overview, Claude Platform Docs[1]
- Managed Agents quickstart, Claude Platform Docs[2]
- Managed Agents files, Claude Platform Docs[3]
- Prompt caching, Claude Platform Docs[4]
- Agent SDK reference (Python), Claude Code Docs[5]
- Use Claude Code in the cloud, Claude Code Docs[6]
- Agents, OpenAI API Docs[7]
- Agents API architecture, OpenAI API Docs[8]
- Configuring Agents, OpenAI API Docs[9]
- Run and continue sessions, OpenAI API Docs[10]
- OpenAI-hosted sandboxes, OpenAI API Docs[11]
- Sandbox lifecycle, OpenAI API Docs[12]
- Files and artifacts, OpenAI API Docs[13]
- Model usage and cost, OpenAI API Docs[14]
- Agents SDK overview, OpenAI API Docs[15]
- Running agents, OpenAI API Docs[16]
- Sandbox agents, OpenAI API Docs[17]
- Pricing, OpenAI API Docs[18]
- Codex Cloud, OpenAI Docs[19]
- Cloud environments, OpenAI Docs[20]
- Codex environments, OpenAI Docs[21]
- Codex on mobile, OpenAI Docs[22]
참고 링크 · 22
- [1] Claude Managed Agents overview, Claude Platform Docs — platform.claude.com
- [2] Managed Agents quickstart, Claude Platform Docs — platform.claude.com
- [3] Managed Agents files, Claude Platform Docs — platform.claude.com
- [4] Prompt caching, Claude Platform Docs — platform.claude.com
- [5] Agent SDK reference (Python), Claude Code Docs — code.claude.com
- [6] Use Claude Code in the cloud, Claude Code Docs — code.claude.com
- [7] Agents, OpenAI API Docs — developers.openai.com
- [8] Agents API architecture, OpenAI API Docs — developers.openai.com
- [9] Configuring Agents, OpenAI API Docs — developers.openai.com
- [10] Run and continue sessions, OpenAI API Docs — developers.openai.com
- [11] OpenAI-hosted sandboxes, OpenAI API Docs — developers.openai.com
- [12] Sandbox lifecycle, OpenAI API Docs — developers.openai.com
- [13] Files and artifacts, OpenAI API Docs — developers.openai.com
- [14] Model usage and cost, OpenAI API Docs — developers.openai.com
- [15] Agents SDK overview, OpenAI API Docs — developers.openai.com
- [16] Running agents, OpenAI API Docs — developers.openai.com
- [17] Sandbox agents, OpenAI API Docs — developers.openai.com
- [18] Pricing, OpenAI API Docs — developers.openai.com
- [19] Codex Cloud, OpenAI Docs — learn.chatgpt.com
- [20] Cloud environments, OpenAI Docs — learn.chatgpt.com
- [21] Codex environments, OpenAI Docs — learn.chatgpt.com
- [22] Codex on mobile, OpenAI Docs — learn.chatgpt.com