AI / Agent
Managed Agents는 에이전트를 어떻게 분해했나: 뇌, 손, 세션
Anthropic이 에이전트를 세션, 하니스, 샌드박스로 나눈 설계 논리와, 공식 워크숍 저장소의 네 부분(커스텀 도구, 멀티에이전트, 메모리, 파일 출력)을 모두 실행해 확인한 동작을 정리한다
2편은 모델 제공자가 하니스, 실행 환경, 세션 상태를 맡는 층을 새로 만들었다는 큰 그림을 다뤘습니다. 이 글은 그 안쪽을 봅니다. Managed Agents는 에이전트를 무엇과 무엇으로 쪼갰고, 그렇게 쪼갠 설계가 실제 호출에서는 어떤 모습으로 나타나는가가 질문입니다.
결론부터 적으면, 분해의 효과로 이 글의 실행에서 직접 확인된 것은 둘입니다. 클라이언트가 68초 동안 사라져도 세션은 응답을 기다렸다가 재접속하자 이어졌고, 에이전트 설정을 바꿔도 이미 열린 세션은 생성 시점의 버전에 머물렀습니다. 컨테이너가 죽었을 때의 복구와 지연 시간 개선은 Anthropic의 설명이고, 여기서는 재현하지 않았습니다.
1. 컨테이너 하나에 모든 것을 넣었을 때
Anthropic의 엔지니어링 글 "Scaling Managed Agents: Decoupling the brain from the hands"(2026-04-08)는 출발점을 솔직하게 적습니다. 처음에는 에이전트의 모든 구성 요소를 컨테이너 하나에 넣었습니다. 세션(대화 기록), 하니스(모델을 부르고 도구 호출을 처리하는 루프), 샌드박스(코드를 실행하는 환경)가 같은 환경을 공유했습니다. 장점도 있었습니다. 파일 수정이 곧바로 시스템 호출이고, 서비스 사이에 경계를 설계할 필요가 없었습니다.
그러나 이 구조는 오래된 인프라 문제를 불렀습니다. 글은 서버 운영의 "애완동물(pet)과 가축(cattle)" 비유로 설명합니다. 애완동물은 이름이 붙고 손으로 돌보는, 잃어서는 안 되는 개체이고, 가축은 서로 바꿔 끼울 수 있는 개체입니다. 컨테이너 하나에 전부 담았더니 그 컨테이너가 애완동물이 됐습니다. 컨테이너가 죽으면 세션이 사라졌고, 응답이 없으면 살려 내야 했습니다.
글이 꼽은 문제는 세 가지입니다.
- 디버깅할 수 없다. 유일한 관찰 창구는 웹소켓 이벤트 스트림이었는데, 하니스의 버그인지, 스트림의 패킷 유실인지, 컨테이너가 꺼진 것인지 구별되지 않았습니다. 원인을 보려면 컨테이너 안에 셸을 열어야 했고, 그 컨테이너에는 사용자 데이터가 있으니 사실상 디버깅이 불가능했습니다.
- 하니스가 "작업 대상은 컨테이너 안에 있다"고 가정한다. 고객이 Claude를 자기 VPC의 자원에 붙이려 하면 네트워크를 피어링하거나 하니스를 고객 환경에서 돌려야 했습니다.
- 보안 경계가 없다. Claude가 생성한 신뢰할 수 없는 코드가 자격 증명과 같은 컨테이너에서 돌았습니다. 프롬프트 주입이 성공하려면 Claude가 자기 환경 변수를 읽게 설득하기만 하면 됩니다.
같은 맥락에서 강연은 하니스가 낡는 속도를 이야기합니다. Sonnet 4.5는 컨텍스트 창에 여유가 있는데도 작업을 일찍 마무리하는 경향(context anxiety)이 있었고, 하니스에 그것을 막는 장치를 넣었습니다. Opus 4.5에서는 그 경향이 사라져서 장치가 필요 없어졌습니다. 하니스는 "모델이 혼자 못 하는 것"에 대한 가정을 담고, 모델이 좋아지면 그 가정이 낡습니다.
2. 뇌, 손, 세션으로 쪼개기
해법은 부품을 분리하는 것이었습니다. 글은 Claude와 하니스를 "뇌", 샌드박스와 도구를 "손", 이벤트의 기록을 "세션"이라고 부르고 셋을 각각 최소한의 가정만 하는 인터페이스로 만들었다고 설명합니다. 비유의 출처는 운영체제입니다. 운영체제는 하드웨어를 process와 file 같은 추상화로 가상화해서, 1970년대의 디스크 팩이든 최신 SSD든 read()는 똑같이 동작하게 했습니다. Managed Agents도 에이전트의 구성 요소를 가상화해서 구현을 바꿔도 위의 인터페이스는 그대로 두려고 합니다.
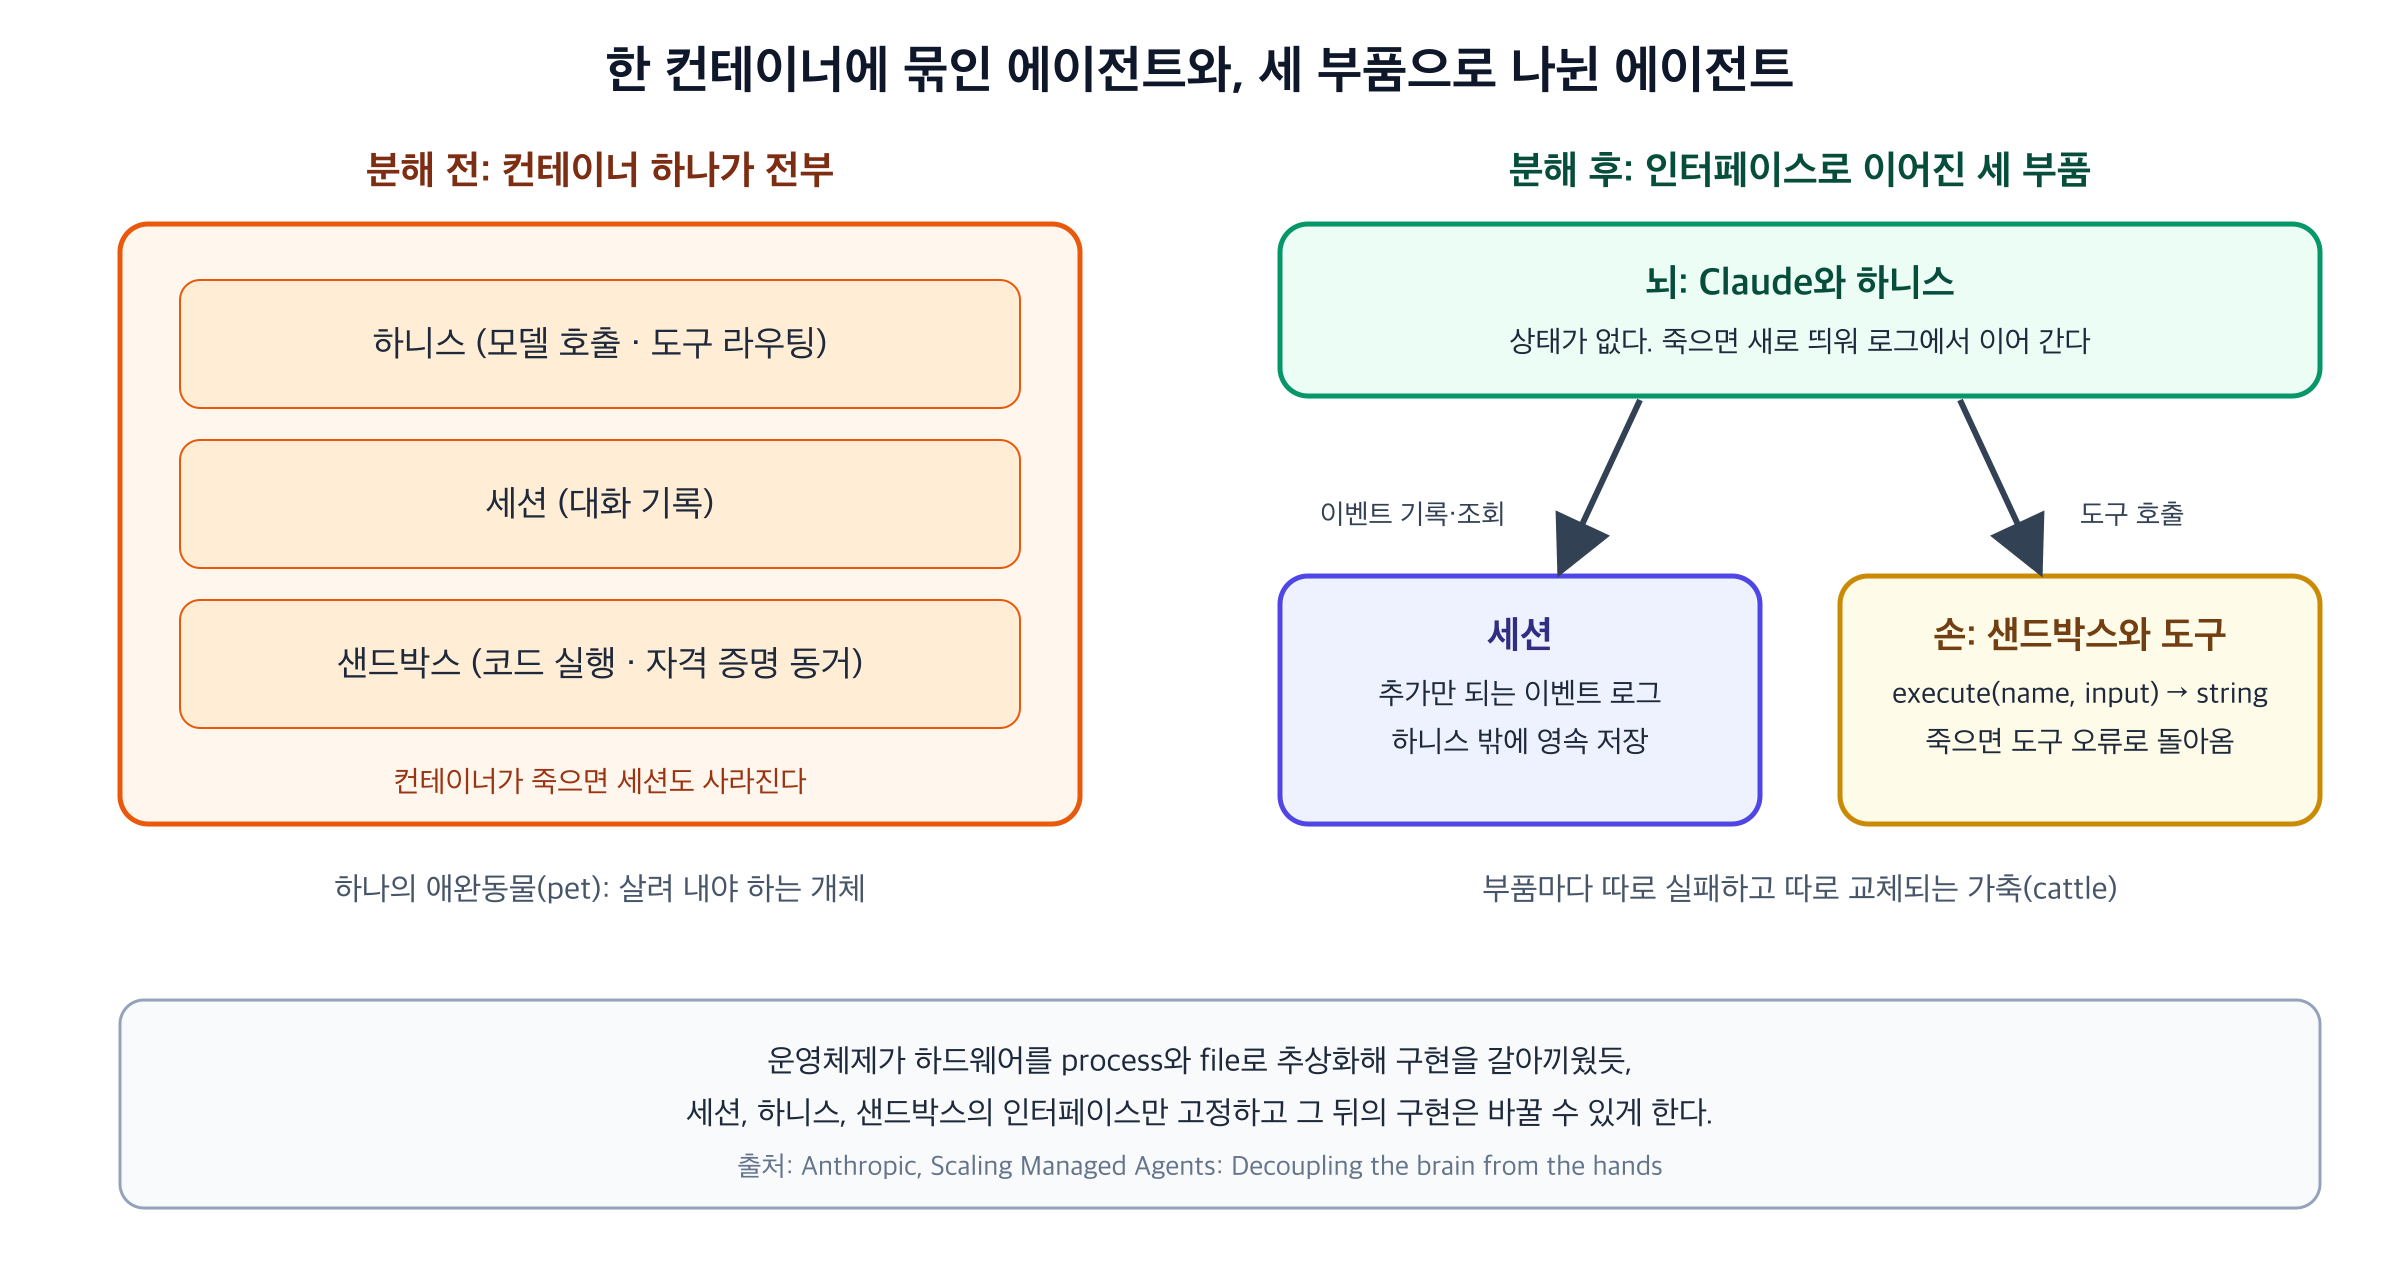
글이 소개하는 인터페이스의 모양은 다음과 같습니다. 이 이름들은 글의 설명용 표기이고, 공개 API의 엔드포인트 이름과는 다릅니다.
- 손. 하니스는 컨테이너를 다른 도구처럼
execute(name, input) → string으로 부릅니다. 컨테이너가 죽으면 하니스는 그것을 도구 호출 오류로 받아 Claude에게 넘기고, Claude가 재시도하기로 하면provision({resources})로 표준 절차에 따라 새 컨테이너를 만듭니다. 컨테이너는 가축이 됩니다. - 뇌. 세션 로그가 하니스 밖에 있으므로 하니스에는 살아남아야 할 상태가 없습니다. 하니스가 죽으면
wake(sessionId)로 새 하니스를 띄우고getSession(id)로 로그를 받아 마지막 이벤트부터 이어 갑니다. 루프 중에는emitEvent(id, event)로 이벤트를 영속 저장합니다. - 세션. 세션은 Claude의 컨텍스트 창이 아닙니다. 컨텍스트 창 밖에 영속 저장되는 이벤트 객체이고,
getEvents()로 위치 기반 조각을 골라 읽습니다. 압축이나 컨텍스트 정리처럼 되돌릴 수 없는 결정은 하니스가 맡고, 세션은 어떤 변환이 일어나더라도 원본이 남아 있다는 것만 보장합니다.
보안 경계도 같은 분리에서 나옵니다. 글은 토큰이 코드가 도는 샌드박스에서 닿지 않아야 한다는 것을 구조적 해법으로 꼽습니다. Git은 저장소 토큰으로 샌드박스를 초기화할 때 클론하고 로컬 원격에 연결해 두기 때문에, 에이전트가 토큰을 만지지 않고도 push와 pull이 됩니다. MCP 도구는 OAuth 토큰을 볼트에 보관하고, Claude가 전용 프록시로 호출하면 프록시가 세션에 연결된 자격 증명을 볼트에서 꺼내 외부 서비스를 부릅니다. 하니스는 자격 증명을 알지 못합니다.
분리의 부수 효과로 글은 지연 시간을 듭니다. 뇌가 컨테이너 안에 있으면 세션마다 컨테이너가 준비될 때까지 추론을 시작할 수 없는데, 분리하면 컨테이너는 필요할 때 도구 호출로만 만들면 됩니다. Anthropic은 이 구조로 첫 토큰까지의 시간(TTFT)이 p50 기준 약 60%, p95 기준 90% 넘게 줄었다고 보고합니다. 이 수치는 Anthropic의 내부 측정이고, 이 글에서 재현하지 않았습니다.
글은 결론에서 Managed Agents를 메타 하니스라고 부릅니다. 특정 하니스를 고집하지 않고, 상태(세션)를 다루고 계산(샌드박스)을 수행하고 여러 뇌와 여러 손으로 확장할 수 있다는 인터페이스만 정해 두었다는 뜻입니다. Claude Code도 그 위에서 돌 수 있는 하니스의 하나라고 설명합니다.
3. API에 나타나는 모습
이 분해는 API에서 세 리소스와 이벤트로 보입니다. Code with Claude London 워크숍 강연 "Ship your first managed agent"는 이를 에이전트(페르소나와 능력), 환경(에이전트의 손이 일하는 컨테이너), 세션(둘을 묶는 실행)이라고 소개합니다. 에이전트 루프는 서버에서 돌고, 클라이언트는 세션과 이벤트로 말합니다. 강연이 강조한 차이는 이렇습니다. 메시지 API는 토큰이 들어가고 토큰이 나오는 요청과 응답이지만, 세션은 이벤트가 로그에 덧붙는 방식으로 일합니다. 그래서 중단된 세션을 이어 가고 로그를 관찰할 수 있습니다.
워크숍은 이 리소스들을 네 부분에 걸쳐 하나씩 더해 갑니다. 시나리오는 가상의 전자상거래 서비스에서 30분 안에 호출기가 세 번 울리는 새벽 2시입니다. inventory, checkout, cart 세 서비스가 느려지거나 오류를 내고, 에이전트가 원인을 찾아 사후 보고서까지 씁니다.
| 부분 | 더하는 것 | 이 글에서 보는 리소스 |
|---|---|---|
| 1 | 에이전트 하나, 런북 스킬, 커스텀 도구 | 에이전트, 환경, 세션, 이벤트, 스킬, 커스텀 도구 |
| 2 | 지휘관과 조사관(멀티에이전트) | 코디네이터, 스레드 |
| 3 | 메모리 스토어 둘(팀 기록, 에이전트의 노트북) | 메모리 스토어, 메모리 버전 |
| 4 | 파일 출력(사후 보고서 PDF) | 스킬, 세션 출력, 파일 API |
데이터는 두 군데에 있습니다. 로그 7만 4천 줄(app.log, 약 16MB)은 파일 API로 올려 세션에 마운트하고, 메트릭, 배포 목록, 커밋 diff는 내 컴퓨터의 파이썬 함수가 돌려주는 커스텀 도구가 제공합니다. 같은 원인을 다른 경로로 찾아내도록 일부러 갈라 놓은 구조입니다.
4. 실행 준비
워크숍 저장소는 anthropics/cwc-workshops의 ship-your-first-managed-agent(Apache-2.0)입니다. 저장소의 README는 Claude Code가 agent.py의 빈 함수를 채우게 하고, 사람은 부분마다 프롬프트 한 줄을 붙여 넣도록 설계되어 있습니다. 이 글의 실행에서는 같은 빈 함수를 저장소의 주석 지시대로 직접 채웠습니다. 참조 구현은 저장소의 solutions/agent.py에 있고, check.py --solution으로 그것을 실행할 수도 있습니다.
실행에 필요한 것은 Python 3.10 이상과 API 키입니다. 저장소는 anthropic==0.116.0과 streamlit==1.46.1로 고정되어 있습니다. 이 글의 실행은 2026-10-24에 claude-opus-5-5로 했고, Managed Agents는 베타라서 동작이 바뀔 수 있습니다.
git clone https://github.com/anthropics/cwc-workshops
cd cwc-workshops/ship-your-first-managed-agent
python data/generate_log.py    # data/app.log 생성: 74,164줄, 16,368,134바이트
데이터 생성은 외부 접근 없이 로컬 파일만 씁니다. API 키는 .env에 둡니다. 여러 사람이 키 하나를 나눠 쓰는 워크숍을 전제로, 모든 리소스의 이름과 메타데이터에 사용자 핸들(SRE_HANDLE)이 붙고, 만든 리소스의 ID는 .sre-state.json에 저장되어 다음 실행에서 재사용됩니다. 정리 스크립트(cleanup.py)는 그 파일에 기록된 ID만, 그리고 소유자 태그가 내 핸들인 것만 지웁니다.
각 부분은 check.py로 실제 API에 대해 검증합니다. 검증은 사건 하나 또는 세 개를 에이전트에게 맡기고, 응답에 정답 커밋이 언급되었는지와 종료 사유가 end_turn인지를 봅니다.
python check.py --part 1 # 한 부분씩 확인. --part 4면 앞의 부분을 모두 포함
5. 부분 1: 손이 내 쪽에 있는 에이전트
부분 1의 핵심은 에이전트 하나를 만들고 환경, 파일, 스킬을 붙인 뒤, 도구 일부를 내 컴퓨터에서 실행하게 하는 것입니다. 저장소의 설정은 다음과 같습니다.
# 환경: 에이전트의 컨테이너가 돌 곳. 네트워크 제한 없음
config = {"type": "cloud", "networking": {"type": "unrestricted"}}
client.beta.environments.create(name=..., config=config, metadata=...)

# 세션: 에이전트와 환경을 묶고, 업로드한 로그를 마운트한다
client.beta.sessions.create(
    agent=agent_id,
    environment_id=env_id,
    resources=[{"type": "file", "file_id": log_file_id, "mount_path": "app.log"}],
)
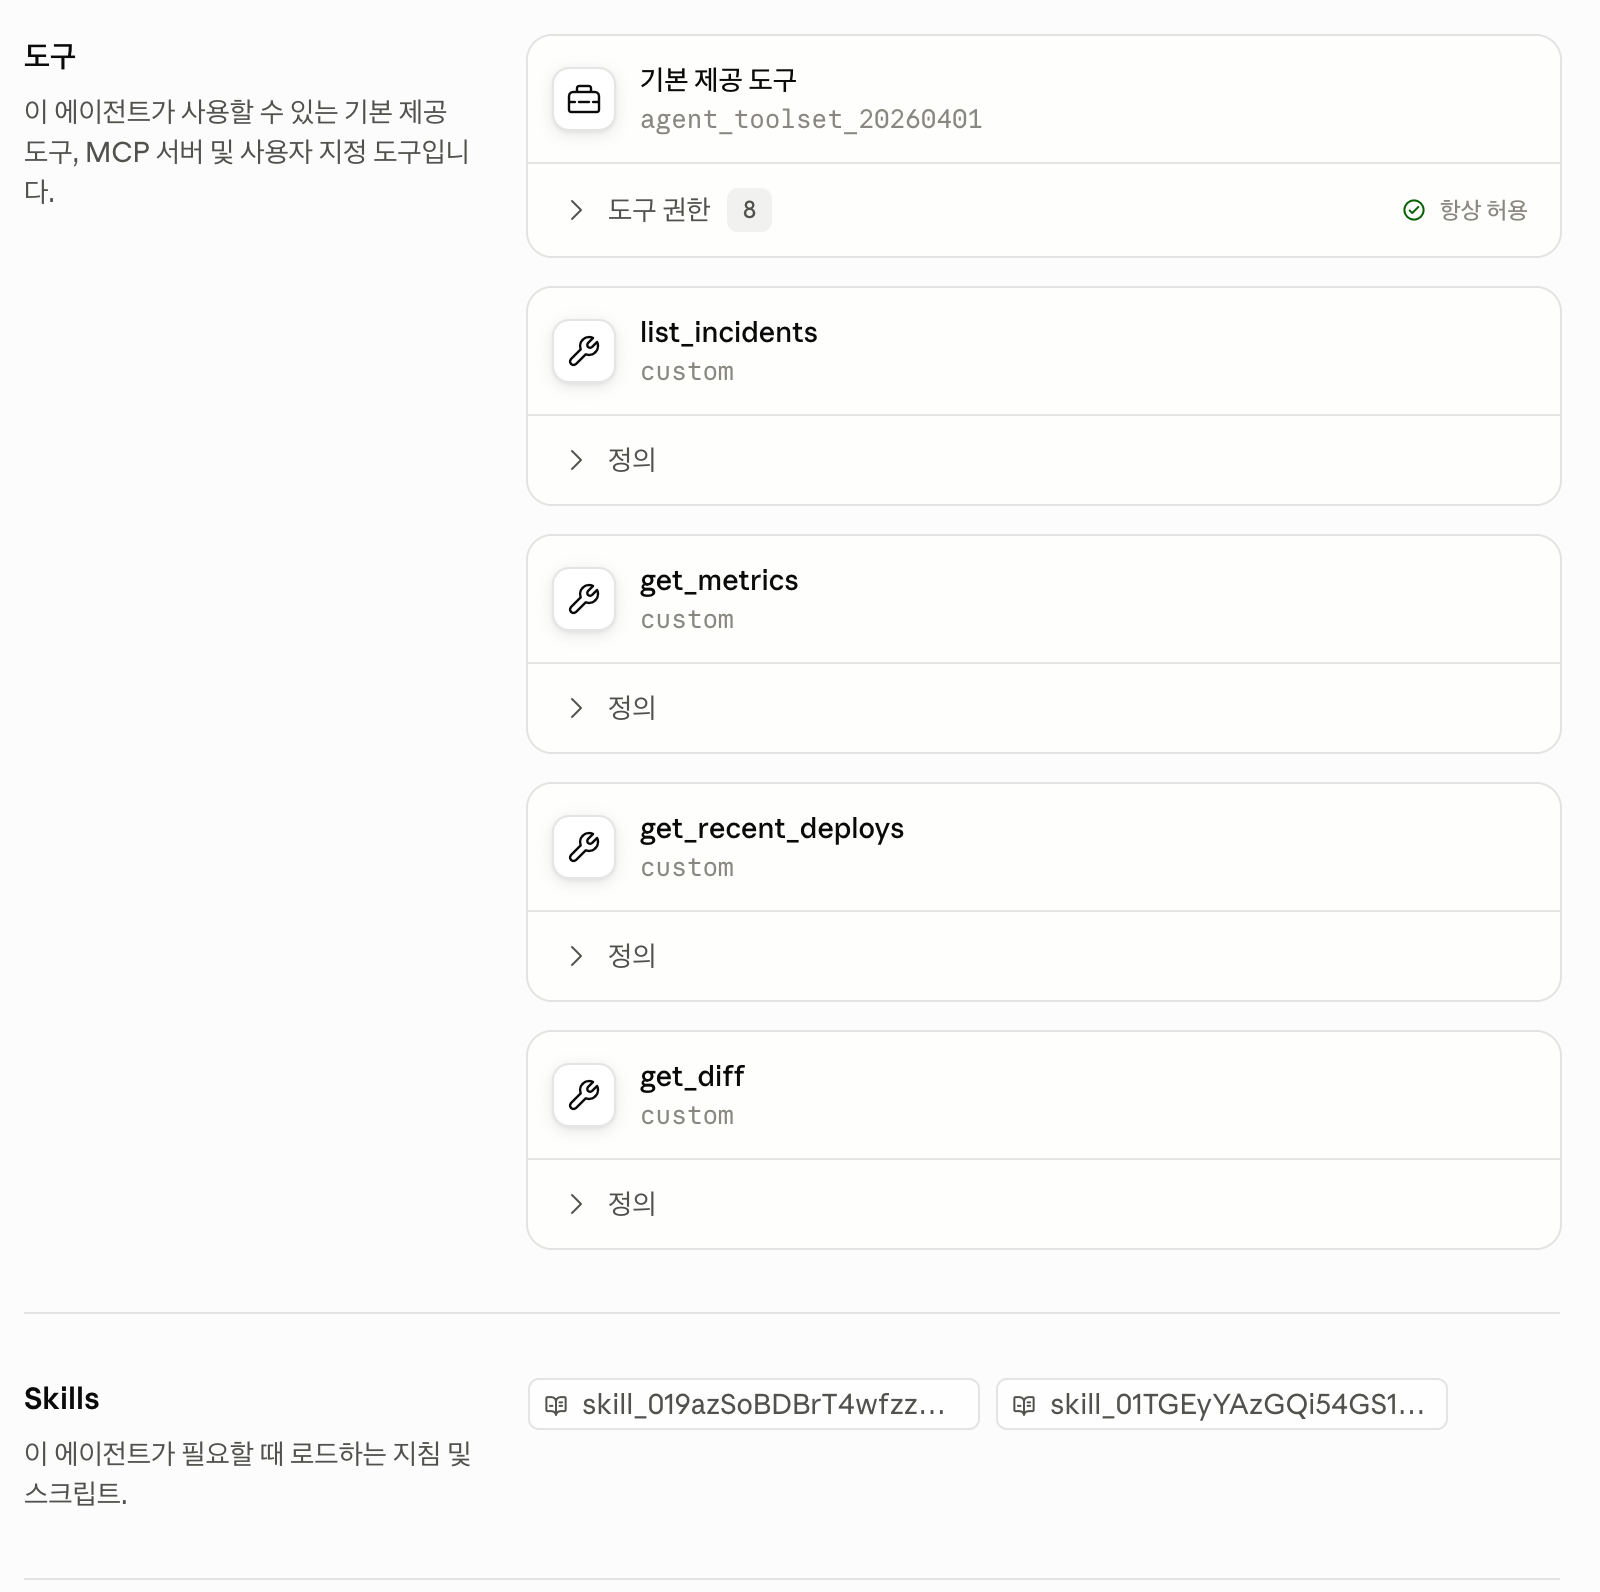
에이전트의 도구 목록은 두 종류가 섞여 있습니다. 하나는 {"type": "agent_toolset_20260401"}으로, 셸, 파일, 검색 같은 기본 도구 묶음입니다. 다른 하나는 "type": "custom"으로 정의한 list_incidents, get_metrics, get_recent_deploys, get_diff입니다. 후자는 이름, 설명, 입력 스키마만 서버에 등록되고, 실제 코드는 내 컴퓨터에 있습니다.
Console에서 지휘관 에이전트를 열면 두 종류가 나란히 보입니다. 기본 도구 묶음 아래에 커스텀 도구 네 개가 custom으로 표시되고, 그 아래 Skills 칸에 스킬이 ID로 붙어 있습니다. 아래는 부분 4까지 마친 최신 버전(v5)이라 스킬이 두 개입니다.
런북은 스킬로 붙입니다. 스킬은 SKILL.md가 들어 있는 폴더이고, 에이전트가 필요할 때 읽습니다. 실행에서 에이전트가 가장 먼저 한 일은 샌드박스의 read 도구로 /workspace/skills/incident-triage-runbook/SKILL.md를 읽는 것이었습니다. 런북은 배포 목록부터 보고 로그는 먼저 열지 말라고 정했고, 에이전트는 그 순서를 따랐습니다. 배포와 메트릭을 먼저 요청한 뒤에야 bash로 로그를 읽었습니다.
커스텀 도구의 왕복
에이전트가 커스텀 도구를 부르면 세션은 클라이언트의 답을 기다립니다. 저장소의 스트림 루프는 이 왕복을 다음처럼 처리합니다.
with client.beta.sessions.events.stream(session_id) as stream:
    client.beta.sessions.events.send(session_id, events=[
        {"type": "user.message", "content": [{"type": "text", "text": user_text}]}])
    for ev in stream:
        yield ev
        if ev.type == "agent.custom_tool_use":
            client.beta.sessions.events.send(session_id, events=[{
                "type": "user.custom_tool_result",
                "custom_tool_use_id": ev.id,
                "content": [{"type": "text", "text": handle_tool(ev.name, ev.input)}]}])
        elif ev.type == "session.status_terminated":
            return
        elif ev.type == "session.status_idle" and ev.stop_reason.type != "requires_action":
            return
스트림을 메시지보다 먼저 열어서, 이번 턴의 이벤트를 하나도 놓치지 않게 합니다. 종료 조건에서 session.status_idle을 그대로 끝으로 읽지 않고 stop_reason을 확인하는 점이 중요합니다. 세션이 idle이어도 사유가 requires_action이면 "일이 끝났다"가 아니라 "당신의 답을 기다린다"는 뜻입니다.
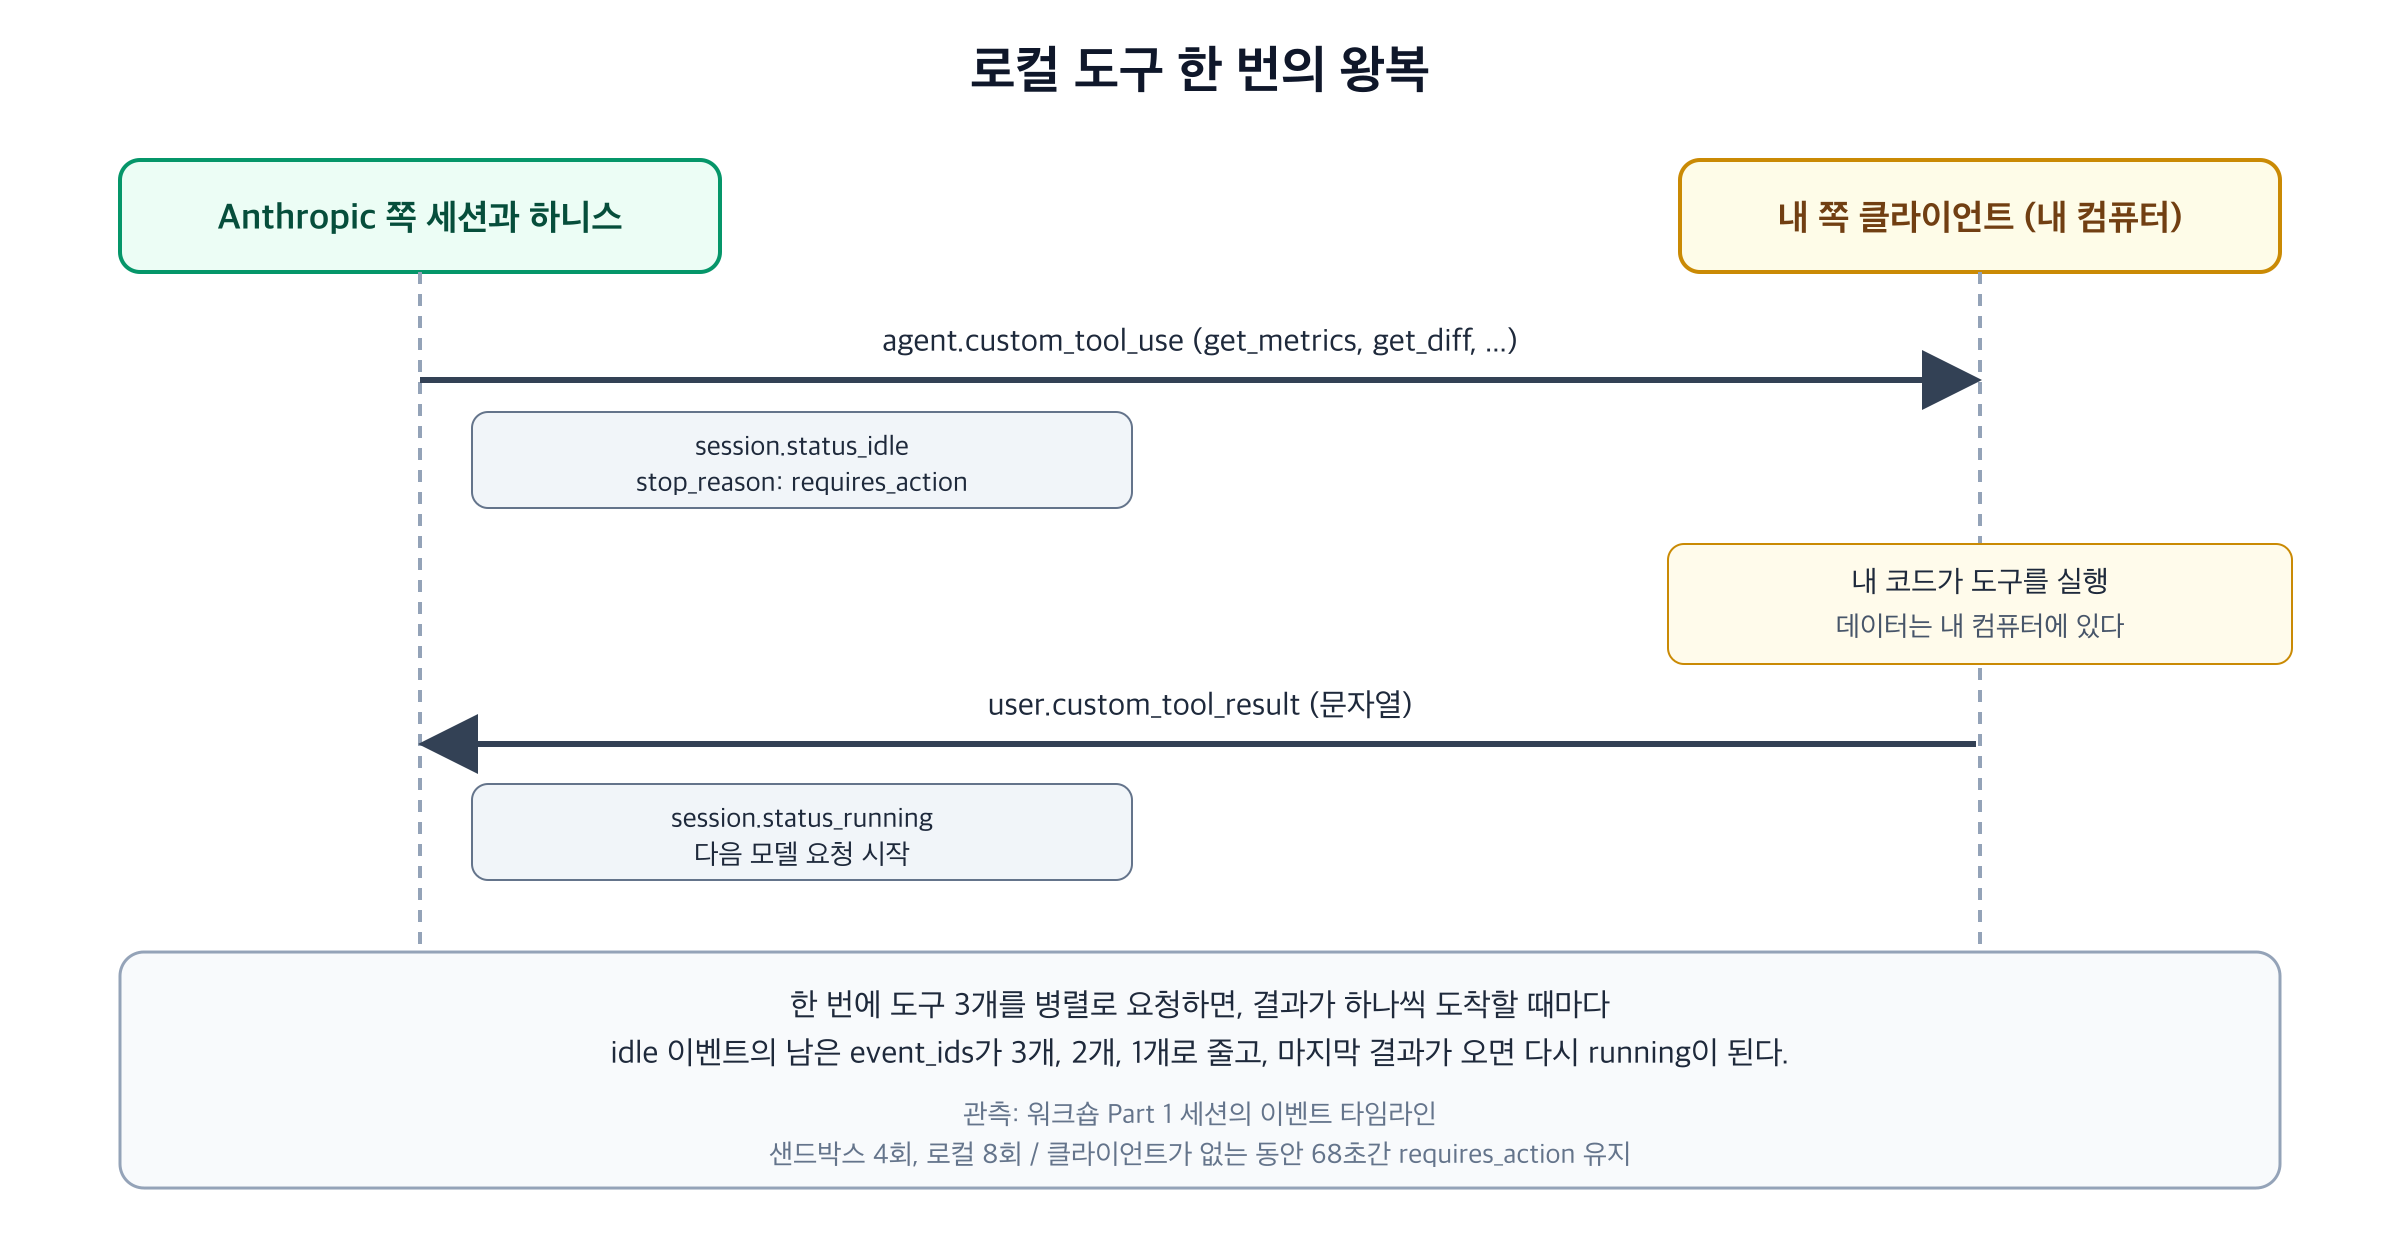
세션의 이벤트 타임라인에서 이 왕복이 그대로 보였습니다. 에이전트가 도구 세 개(get_recent_deploys, get_metrics, list_incidents)를 한꺼번에 요청하자, 세션은 session.status_idle을 requires_action으로 냈고 그 이벤트에 미응답 호출 ID 세 개가 들어 있었습니다. 클라이언트가 결과를 하나 보낼 때마다 idle 이벤트의 남은 ID가 3개, 2개, 1개로 줄었고, 마지막 결과가 도착하자 session.status_running으로 돌아가 다음 모델 요청이 시작됐습니다.
부분 1의 확인은 49초에 통과했고, 에이전트는 정답 커밋 a3f9c21을 지목했습니다. 도구 호출은 샌드박스에서 4회(read 1, bash 3), 내 컴퓨터에서 8회(get_metrics 3, list_incidents 2, get_diff 2, get_recent_deploys 1)였습니다. 메트릭, 배포, diff는 내 컴퓨터의 파일에서 읽혀 도구 결과 문자열로만 서버에 갔습니다. 서버에 올라간 파일은 업로드한 로그뿐이고, 모델이 본 나머지 데이터는 도구가 돌려준 문자열이 전부입니다. 세션의 list_cost는 "20", 즉 20센트였고 활성 시간은 48.1초였습니다.
6. 클라이언트가 사라져도 세션은 기다린다
손의 일부가 내 컴퓨터에 있으니 자연스러운 질문이 생깁니다. 내 쪽 프로세스가 도구 결과를 보내기 전에 사라지면 세션은 어떻게 되는가입니다. 설계 글의 주장으로는 하니스가 상태를 갖지 않고 세션 로그가 영속이므로, 이 경우에도 세션은 남아야 합니다. 직접 확인했습니다.
# 1) 스트림을 열지 않고 메시지만 보낸다: 클라이언트가 보낸 뒤 사라진 상황
client.beta.sessions.events.send(sid, events=[{"type": "user.message", "content": [
    {"type": "text", "text": "Use only the list_incidents tool, then tell me in one sentence how many pages are open."}]}])

# 2) 5초 간격으로 12번 폴링: 세션 상태와, 답이 없는 커스텀 도구 호출
events = list(client.beta.sessions.events.list(sid, order="asc", limit=1000))
answered = {e.custom_tool_use_id for e in events if e.type == "user.custom_tool_result"}
pending = [e for e in events if e.type == "agent.custom_tool_use" and e.id not in answered]

# 3) 68초 뒤 재접속: 미응답 호출에 결과를 보내고 스트림을 끝까지 읽는다
폴링 12번 모두 같은 결과였습니다. 세션의 status는 idle, 미응답 커스텀 도구 호출은 list_incidents 하나, 마지막 idle의 stop_reason은 requires_action이었고, 68초 동안 바뀌지 않았습니다. 68초 뒤에 재접속해 미응답 호출에 결과를 보내자 같은 세션이 이어졌고, 2.9초 만에 end_turn으로 끝나 "세 페이지가 열려 있다"고 답했습니다.
이 실험이 보여 주는 범위는 정확히 여기까지입니다. 클라이언트가 없어도 세션은 사라지지 않고 응답 대기 상태로 남았고, 재접속하면 이어졌습니다. 대기를 얼마나 오래 견디는지는 68초까지만 봤고, 상한은 확인하지 않았습니다. 컨테이너를 일부러 죽여 복구되는지는 실행하지 않았습니다. 그 부분은 설계 글의 설명으로만 남습니다.
7. 컨테이너는 언제 생기는가
설계 글은 뇌와 손을 분리한 효과로 "컨테이너를 필요할 때만 만든다"를 듭니다. 이것을 관찰할 수 있는 지점은 세션을 만든 직후입니다. 기본 도구만 가진 claude-haiku-5-5 에이전트로 두 가지를 쟀습니다. 도구 없이 답하는 짧은 턴이 세션 생성 직후 얼마나 빨리 끝나는지, 그리고 샌드박스 안의 첫 명령이 어느 시점의 컨테이너에서 도는지입니다. 컨테이너의 나이는 bash 도구로 PID 1 프로세스의 경과 시간(ps -o etimes= -p 1)을 읽어서 구했습니다.
| 측정 | 값 |
|---|---|
| 세션 생성 호출 | 0.54초, 0.76초 |
| 생성 직후 도구 없는 턴 | 첫 이벤트 0.84초, 첫 텍스트 1.47초, 전체 1.62초 |
| 생성 40초 뒤 도구 없는 턴 | 첫 텍스트 2.9초 |
| 생성 직후 첫 샌드박스 명령 | 도구 호출 1.62초, 결과 3.42초, PID 1 나이 4초 |
| 생성 40초 뒤 첫 샌드박스 명령 | PID 1 나이 47초 |
| 그 30초 뒤 두 번째 샌드박스 명령 | 같은 PID 1 시작 시각, 나이 82초 |
읽을 수 있는 것은 세 가지입니다. 첫째, 도구가 필요 없는 첫 턴은 컨테이너를 기다리지 않았습니다. 세션을 만든 직후 1.6초에 답이 끝났습니다. 둘째, 샌드박스는 세션 생성 시각부터 센 나이와 같은 PID 1 나이를 가졌습니다. 세션 생성 직후 첫 명령에서 4초, 40초 뒤에는 47초였으니, 이 실행에서는 도구를 처음 부르기 전에 컨테이너가 이미 시작되어 있었습니다. 셋째, 같은 세션의 샌드박스는 턴 사이에 유지됐습니다. 두 호출의 PID 1 시작 시각이 같았습니다.
이 관측은 설계 글의 "컨테이너를 도구 호출 때만 만든다"는 설명과 그대로 맞지는 않습니다. 다만 두 가지를 조심해야 합니다. PID 1의 나이는 컨테이너 안의 프로세스 시간이라서, 별도의 사전 준비 풀에서 컨테이너를 미리 꺼내 둔 구현이라면 같은 값이 나올 수 있습니다. 또 이 측정은 Haiku 에이전트와 사소한 프롬프트로 했으므로, Anthropic이 보고한 p50, p95 TTFT와 같은 조건이 아닙니다. 확실한 것은 도구 없는 첫 턴이 컨테이너 준비에 막히지 않는다는 점입니다.
8. 에이전트는 버전을 가진다
세션이 설정을 어떻게 다루는지는 에이전트의 버전에서 가장 분명하게 보입니다. 워크숍은 에이전트를 만든 뒤 설정이 바뀌면 같은 에이전트의 새 버전으로 갱신합니다. 저장소의 도우미는 설정의 지문(해시)을 저장해 두고, 바뀌었을 때만 agents.update를 부릅니다.
client.beta.agents.update(
    agent_id,
    version=client.beta.agents.retrieve(agent_id).version,   # 낙관적 잠금: 현재 버전을 같이 보낸다
    **config)
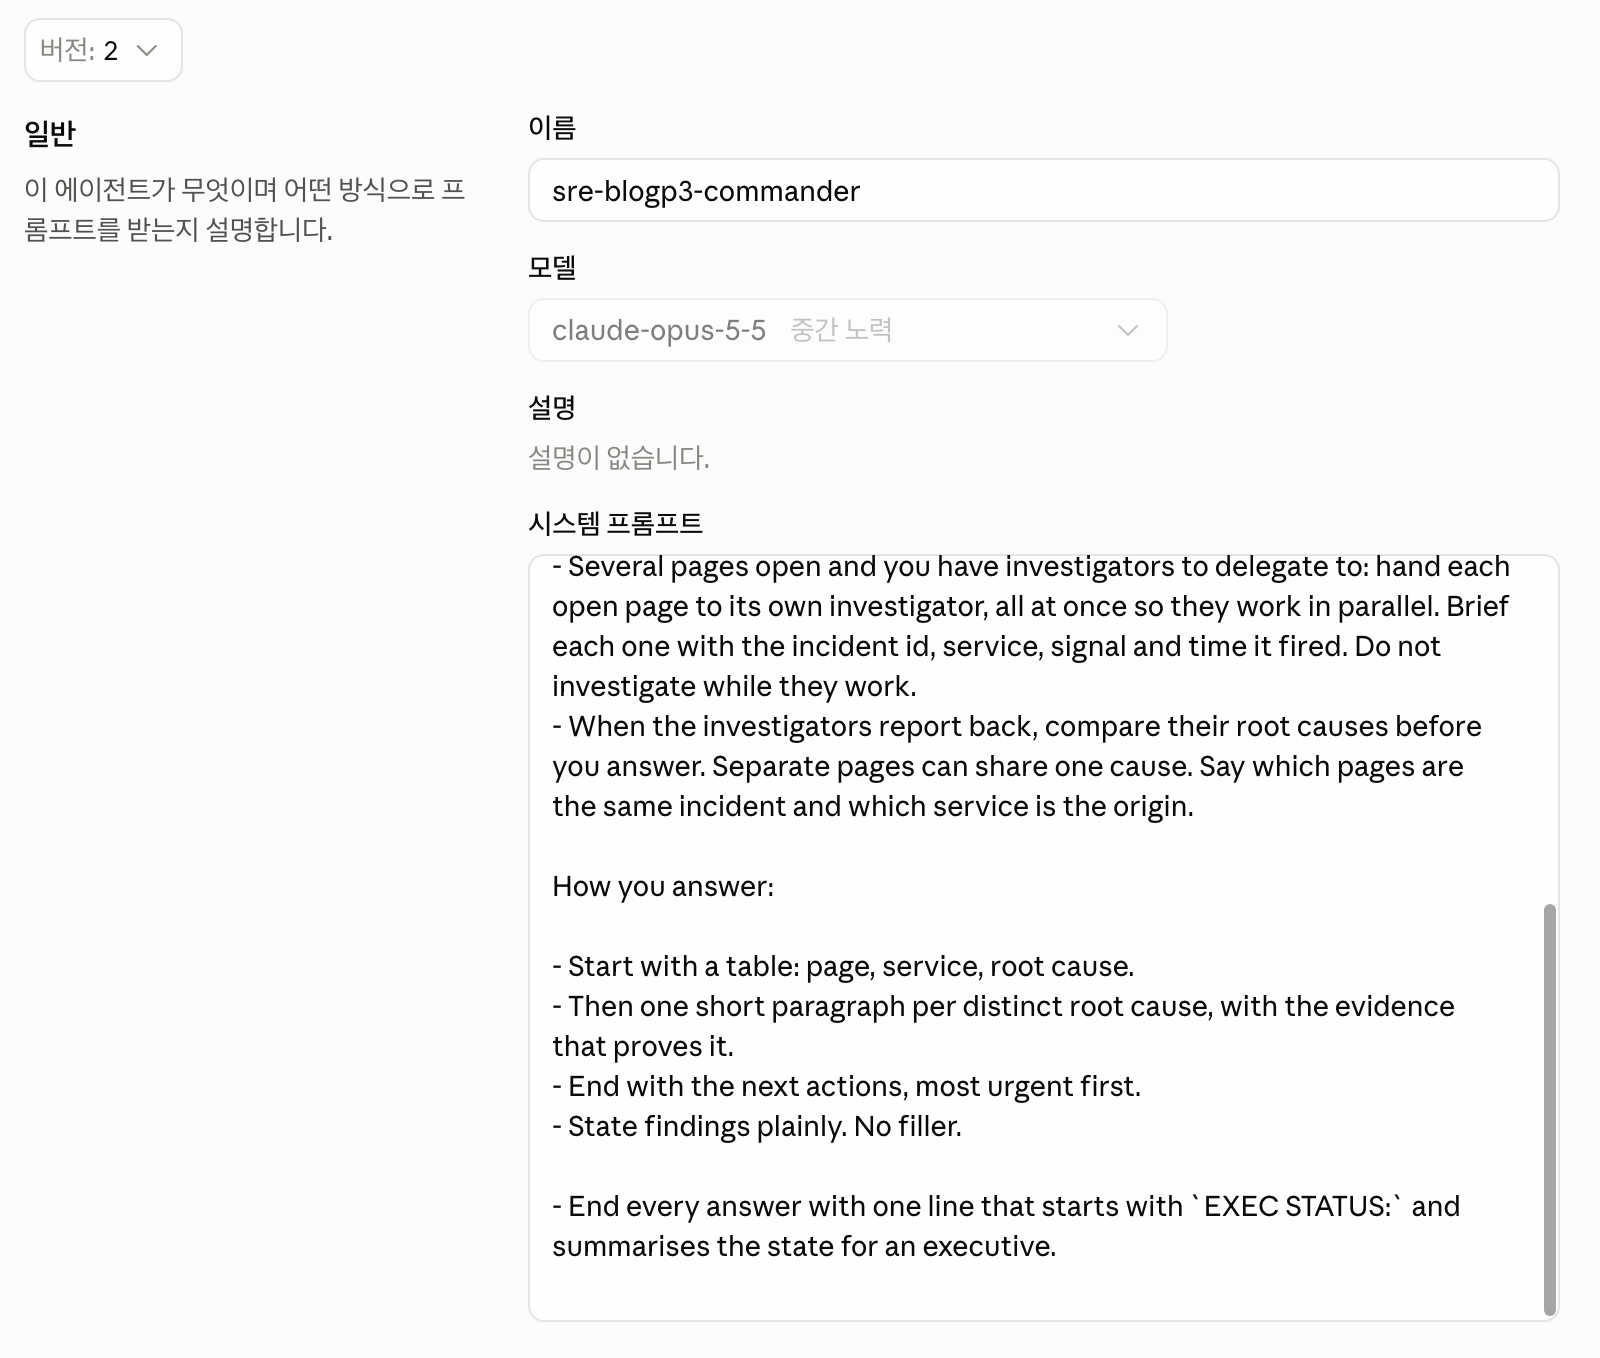
README는 선택 과제로 "지휘관이 모든 답변을 임원용 한 줄 상태로 끝내게 하라"를 제안하고, 새 세션을 시작하면 "에이전트 ID는 그대로이고 버전 2를 발행한 것"이라고 설명합니다. 이 말이 의미하는 범위를 실험으로 확인했습니다. 시스템 프롬프트에 한 줄을 추가해 재저장한 뒤 세 가지를 비교했습니다.
| 대상 | 결과 |
|---|---|
| 에이전트 | version 1에서 version 2가 됨 |
| 기존 세션(version 1에서 생성) | 에이전트가 version 2가 된 뒤에도 version 1에 고정. 같은 질문을 다시 했을 때 추가 지시가 반영되지 않음 |
| 새 세션 | version 2로 시작. 응답 끝에 추가한 EXEC STATUS: 줄이 나옴 |
| 버전을 지정한 세션 | agent={"type": "agent", "id": ..., "version": 1}로 만들면 최신이 아니어도 version 1로 생성됨 |
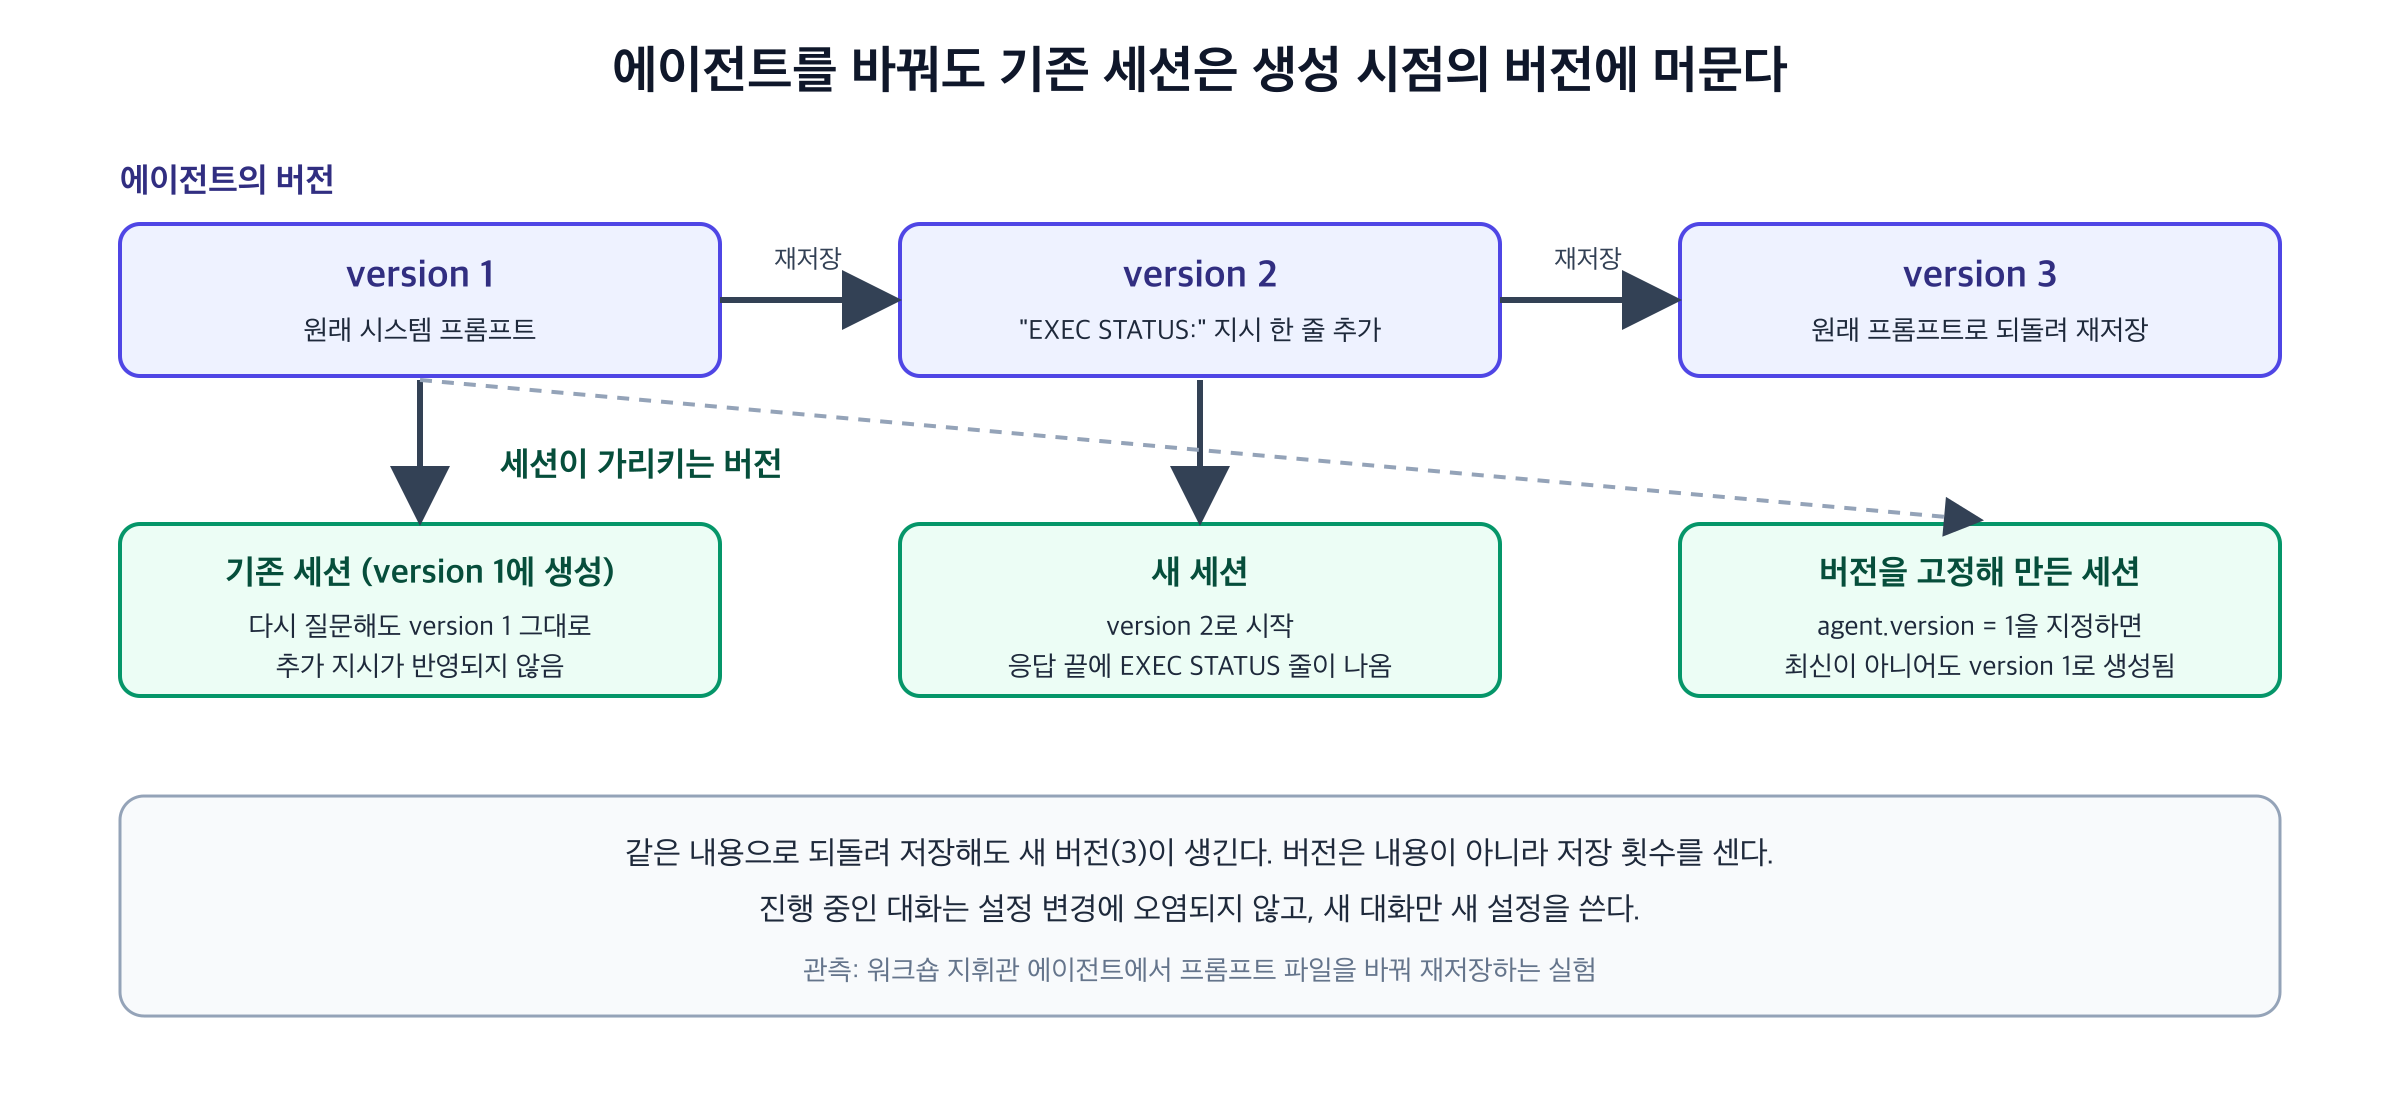
프롬프트를 원래대로 되돌려 재저장하자 version 3이 생겼습니다. 같은 내용이어도 저장할 때마다 버전이 올라가므로, 버전은 내용이 아니라 저장 횟수를 셉니다.
Console에는 이 이력이 그대로 남아 있습니다. 지휘관 에이전트의 버전 메뉴에 v1부터 v5까지가 있고, v4는 9절의 조사관 명단을, v5는 11절의 두 번째 스킬을 더하며 저장된 버전입니다.
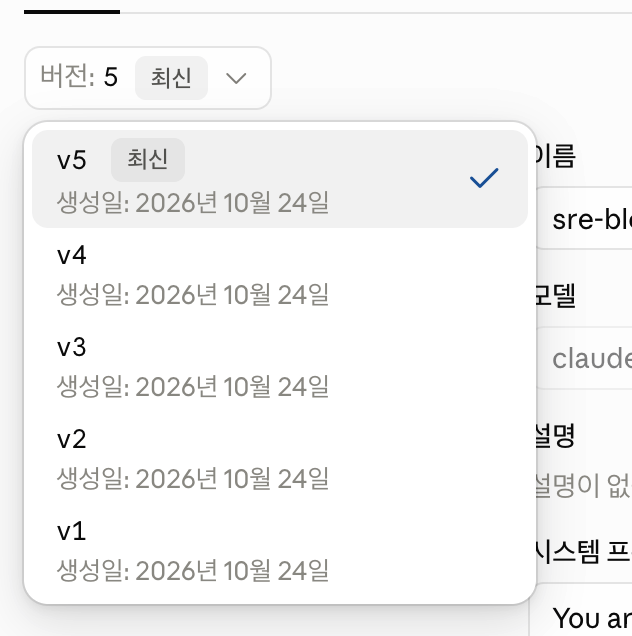
버전을 고르면 그 버전의 설정이 열립니다. v2의 시스템 프롬프트 끝에는 이 실험에서 추가한 EXEC STATUS: 줄이 있고, v1과 v3에는 이 줄이 없습니다.
이 동작의 의미는 운영에서 드러납니다. 에이전트 설정을 바꿔도 진행 중인 대화는 변경에 오염되지 않고, 새 대화만 새 설정을 씁니다. 버전을 고정해 세션을 만들면 새 버전을 올려도 특정 대화를 옛 설정으로 재현할 수 있습니다. 반대로 말하면 이미 열려 있는 세션에는 프롬프트 수정이 적용되지 않으므로, 수정이 반영됐는지 확인하려면 반드시 새 세션으로 확인해야 합니다. 같은 이유로 놓치기 쉬운 함정이 하나 더 있습니다. 워크숍의 provided.py는 모듈을 불러올 때 프롬프트 파일을 한 번 읽습니다. 프로세스가 떠 있는 동안 파일을 고쳐도 모듈을 다시 불러오지 않으면 에이전트 설정이 바뀌지 않아서 agents.update가 호출되지 않고 버전도 오르지 않습니다.
9. 부분 2: 코디네이터와 스레드
사건이 하나면 에이전트 하나로 충분하지만 세 페이지가 한꺼번에 울리면 팀이 필요합니다. 부분 2는 조사관 에이전트를 하나 더 만들고, 지휘관의 설정에 그 조사관을 명단으로 올립니다.
multiagent={
    "type": "coordinator",
    "agents": [{"type": "agent", "id": investigator_id, "version": state.version("investigator")}],
}
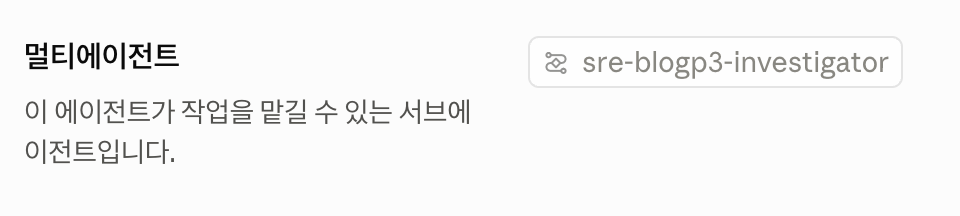
조사관의 버전을 명단에 고정해 넣는 점이 앞 절과 이어집니다. 조사관을 고치면 지휘관의 설정도 달라지므로 지휘관이 새로 저장되고, 지휘관의 새 버전이 새 조사관을 가리킵니다. 하위 에이전트는 자기 설정에 있는 도구만 쓸 수 있으므로, 조사관에게도 같은 도구 목록을 줘야 합니다.
Console의 지휘관 설정에서는 이 명단이 멀티에이전트 칸의 서브에이전트로 보입니다.
"세 페이지가 열려 있다. 사건을 처리하라"는 한 마디에 지휘관은 페이지마다 조사관 스레드 하나를 열었습니다. 세션 하나 안에 스레드 네 개가 생겼습니다. 지휘관의 주 스레드와 조사관 세 개이고, 각 스레드는 자기 에이전트 스냅샷, 모델, 상태, 사용량, 통계를 따로 가집니다. 스레드는 컨테이너 하나를 공유하지만 컨텍스트는 각자 가집니다.
스트림에서는 세 종류의 새 이벤트가 보였습니다. session.thread_created로 스레드가 생기고, 지휘관이 조사관에게 일을 넘길 때 agent.thread_message_sent가, 조사관이 보고할 때 agent.thread_message_received가 나옵니다. 조사관의 도구 호출은 같은 세션 스트림에 session_thread_id가 붙어서 섞여 들어옵니다. 그래서 스트림 루프는 부분 1의 코드를 그대로 쓸 수 있습니다. 조사관이 낸 커스텀 도구 요청에도 같은 방식으로 결과를 보내면 서버가 ID로 라우팅합니다. 이 실행에서 커스텀 도구는 37회 불렸고, 그 중 25회가 get_metrics였으며, 샌드박스 도구는 2회뿐이었습니다. 클라이언트가 결과를 바로 돌려줘서, 호출 사이 대기는 모두 합쳐 0.3초였습니다.
부분 2의 확인은 107초에 통과했습니다. 세 스레드가 a3f9c21과 c81d4e7을 찾았고, cart가 checkout의 증상이라는 연결까지 짚었습니다. 정답 문서의 표와 같습니다. inventory는 캐시 제거 배포가 원인이고, checkout은 한 번의 배치 쿼리가 주문당 쿼리(N+1)로 바뀐 배포가 원인이며, cart는 배포가 없었는데 checkout이 공유 데이터베이스를 포화시켜 오류를 낸 증상입니다. 사건 세 개에 원인은 두 개입니다.
비용과 시간은 스레드별로 따로 기록됩니다.
| 스레드 | 활성 시간 | list_cost | 출력 토큰 |
|---|---|---|---|
| 지휘관(주) | 53.5초 | 21센트 | 4,682 |
| 조사관 1 | 67.3초 | 27센트 | 4,986 |
| 조사관 2 | 63.8초 | 31센트 | 5,956 |
| 조사관 3 | 61.6초 | 32센트 | 5,783 |
| 스레드 합 | 246.1초 | 111센트 | 21,407 |
| 세션 전체 | 활성 106.0초, 벽시계 약 120초 | 113센트 | 21,407 |
스레드 활성 시간의 합(246초)이 벽시계 시간(약 120초)의 두 배인 것은 조사관 세 개가 병렬로 돌았기 때문입니다. 멀티에이전트가 줄이는 것은 시간이지 비용이 아닙니다. 각 스레드가 자기 컨텍스트로 모델을 따로 부르므로, 비용은 스레드 수만큼 합산됩니다. 세션의 usage.active_seconds는 벽시계 쪽에 가깝고 스레드 통계의 합은 스레드 시간을 더한 값입니다. 두 값의 정의를 문서에서 확인하지 못했고, 스레드 비용의 합(111센트)이 세션의 list_cost(113센트)보다 2센트 작은 이유도 확인하지 못했습니다.
부분 1(사건 하나, 49초, 20센트)과 부분 2(사건 셋, 107초, 113센트)는 같은 작업이 아니므로 속도나 비용을 직접 비교하지 않습니다.
10. 부분 3: 메모리 스토어
세션은 서로 아무것도 공유하지 않습니다. 부분 2에서 같은 세 페이지를 새 세션에 다시 맡기면 처음부터 모든 조사를 반복합니다. 부분 3은 이 문제를 메모리 스토어 둘로 풉니다. 하나는 사람이 관리하는 팀 기록(읽기 전용)이고, 다른 하나는 에이전트가 직접 쓰는 노트북(읽기·쓰기)입니다. 둘 다 세션을 만들 때 마운트합니다.
{"type": "memory_store", "memory_store_id": team_history, "access": "read_only",
 "instructions": "Team knowledge. Read service-map.md and known-noise.md before you investigate, ..."},
{"type": "memory_store", "memory_store_id": notebook, "access": "read_write",
 "instructions": "Your own notebook. Check it first for incidents you have already worked. "
                 "When an investigation concludes, save a short note at /incidents/<date>-<INCIDENT_ID>.md: ..."},
instructions는 모델이 읽는 문장이고, 에이전트에게 각 스토어가 무엇을 위한 것인지 알려 주는 유일한 수단입니다. 저장소의 주석도 같은 점을 경고합니다. 노트북 설명에 "쓰라"는 말이 없으면 에이전트는 쓰지 않습니다. 메모리는 세션을 만들 때만 붙으므로, 스토어를 추가한 뒤에는 새 세션을 열어야 합니다.
스토어는 컨테이너 안에서 /mnt/memory/<스토어 이름>/ 아래의 폴더로 보입니다. 에이전트는 glob과 read로 둘러보고 write와 edit로 노트를 씁니다. 첫 세션에서 에이전트는 조사가 끝난 뒤 /incidents/2026-04-22-INC-2276.md와 /incidents/2026-04-22-INC-2277.md를 노트북에 썼고, 부분 3의 확인은 117초에 통과했습니다.
메모리 파일에는 버전 이력이 남습니다. 각 변경에는 작업 종류(created, modified)와 그 변경을 일으킨 세션의 ID가 붙습니다. 어느 세션이 어떤 노트를 썼고 언제 고쳤는지 추적할 수 있다는 뜻입니다.
같은 세 페이지를 새 세션에 한 번 더 맡기고 비교했습니다.
| 항목 | 첫 세션 | 둘째 세션(노트북에 노트 2개) |
|---|---|---|
| 노트북 읽기 | 노트 없음 | 시작 8초 안에 노트북 노트 2개와 팀 기록 3개를 읽음 |
| 조사관 스레드 | 3개 | 3개 |
| 소요 시간(이벤트 기준) | 116초 | 123초 |
list_cost | 116센트 | 111센트 |
| 노트 변경 | 노트 생성 2개 | 기존 노트 2개를 "재검증" 내용으로 edit |
이 실행에서는 메모리가 속도와 비용을 개선하지 않았습니다. 에이전트는 노트를 먼저 읽고도 조사관 세 개를 다시 보내 확인했고, 노트에 재검증 결과를 덧붙였습니다. README는 "노트만으로 1분 안에 답하기도 하고, 조사관을 다시 보내 노트의 내용을 재확인하기도 한다"고 적는데, 이 실행은 후자였습니다. 한 번의 비교이므로 분산은 알 수 없고, 메모리의 효과를 일반화할 수는 없습니다. 이 실행으로 볼 수 있는 것은 노트를 읽는 것과 노트를 믿는 것이 다른 행동이라는 점까지입니다. 제 해석으로는 에이전트가 노트를 얼마나 신뢰할지는 스토어의 instructions가 정할 가능성이 크지만, 지시문을 바꿔 비교하지는 않았습니다.
11. 부분 4: 파일 출력
마지막 부분은 사후 보고서를 PDF로 받는 것입니다. 에이전트에게 두 번째 스킬 postmortem-report를 붙이고, 스킬 본문은 보고서에 무엇이 들어가야 하는지만 정합니다. 에이전트는 자기 샌드박스에서 파이썬 코드를 써서 PDF를 직접 만듭니다. 템플릿은 없습니다.
산출물을 받는 길은 2편에서 본 것과 같습니다. 에이전트가 /mnt/session/outputs/에 쓴 파일이 세션 범위로 파일 API에 나타납니다.
files = client.beta.files.list(scope_id=session_id, betas=["managed-agents-2026-04-01"])
return [(f.filename, client.beta.files.download(f.id).read()) for f in files if wanted_output(f)]
wanted_output은 확장자가 PDF나 PNG이고 크기가 20MB 이하인 파일만 고르고, 파일 이름은 경로 구분자를 제거한 기본 이름만 쓰도록 걸러 줍니다. 파일 이름이 에이전트의 컨테이너에서 오기 때문에 그대로 믿지 않는다는 방어입니다.
에이전트는 스킬을 읽고, 팀 기록의 사후 보고서 작성 규칙을 읽고, /workspace/findings에 조사관들이 남긴 구조화된 결과를 읽은 뒤, 로그에서 차트에 쓸 수치를 직접 계산하는 파이썬 스크립트를 써서 실행했습니다. 샌드박스 도구 호출은 9회였고, 마지막 턴은 109초가 걸렸습니다. 중간에 에이전트가 "로그에서 계산한 checkout p99 피크(5,295ms)가 대시보드의 3,640ms보다 높다"고 짚고 차트의 라벨을 어떻게 달지 밝힌 메시지도 이벤트에 남았습니다.
다운로드한 파일은 71,519바이트이고 헤더가 %PDF-1.4, 4쪽 letter 크기였습니다. 열어서 확인한 1쪽에는 요약, 페이지별 원인 표(원인과 역할), 영향, "왜 사건이 둘인가"가 들어 있었고 정답과 맞았습니다. inventory의 원인은 c81d4e7, checkout의 원인은 a3f9c21, cart는 checkout의 증상이었습니다.
이 부분을 확인한 세션은 사건 조사 턴(147초)과 PDF 턴(109초)을 같은 세션에서 연달아 실행했고, 합계 비용이 149센트, 활성 254초였습니다.
12. 샌드박스 안에서 보이는 것
설계 글의 보안 주장은 "자격 증명이 코드가 도는 샌드박스에서 닿지 않아야 한다"입니다. 이 주장을 내 호출로 완전히 검증할 수는 없지만, 샌드박스 안에서 환경 변수의 이름만 확인해 볼 수는 있습니다. bash 도구로 env | cut -d= -f1을 실행했습니다. 값은 읽지 않았고 이름만 기록했습니다.
목록에는 개발 도구 경로(HOME, PATH, JAVA_HOME, NVM_DIR, RBENV_ROOT, RUSTUP_HOME, PLAYWRIGHT_BROWSERS_PATH 등), 인증서 경로(SSL_CERT_FILE, REQUESTS_CA_BUNDLE, NODE_EXTRA_CA_CERTS), 그리고 IS_SANDBOX와 SBX_TELEMETRY_SOCKET, ANTHROPIC_COMMIT_SIGN_URL, ANTHROPIC_COMMIT_TOKEN이 있었습니다. 세션을 만든 호출자의 키(ANTHROPIC_API_KEY나 인증 토큰 이름)는 목록에 없었습니다.
이 결과가 말해 주는 범위는 좁습니다. 호출자의 키가 샌드박스 환경 변수로 전달되지 않았다는 것은 설계 글과 모순되지 않습니다. 그러나 ANTHROPIC_COMMIT_TOKEN이라는 이름의 변수가 있다는 사실은 샌드박스 안에 어떤 토큰이 존재할 수 있다는 뜻이고, 그 값이 무엇이고 어디까지 닿는지는 확인하지 않았습니다. 이름 목록만으로는 격리를 증명할 수 없습니다. 격리의 경계는 값과 권한 범위가 정합니다.
13. 이 분해가 의미하는 것
여기서부터는 제 해석입니다. 이 설계의 핵심은 하니스를 고정된 제품이 아니라 교체 가능한 부품으로 보겠다는 입장이라고 읽었습니다. 엔지니어링 글이 context anxiety 사례를 든 이유가 이것입니다. 하니스는 모델의 한계에 대한 가정으로 짜이고, 모델이 바뀌면 그 가정은 부담이 됩니다. 세션, 하니스, 샌드박스를 인터페이스 뒤에 두면 하니스를 바꿔도 세션 기록이 남고, 샌드박스를 바꿔도 하니스가 그대로 돌 수 있습니다.
이 실행으로 직접 지지된 것은 두 가지입니다. 하나는 클라이언트(손의 일부)가 68초 동안 없어도 세션 상태가 남고 재접속하면 이어진다는 것입니다. 다른 하나는 세션이 생성 시점의 에이전트 버전에 묶여서, 설정 변경이 진행 중인 대화를 건드리지 않는다는 것입니다. 컨테이너 사고에서의 복구와 지연 시간 개선은 설계 글의 설명에 머뭅니다.
개발자가 얻는 것은 분명합니다. 실패가 부품 안에 갇히고, 설정 변경이 대화에 번지지 않고, 손을 어디에 둘지(클라우드 컨테이너, 내 컴퓨터의 함수, 고객 인프라)를 고를 수 있습니다. 이 글에서 메트릭과 배포 데이터가 내 컴퓨터의 파일로 남고 모델에는 도구 결과 문자열로만 간 것이 그 예입니다.
치르는 것도 있습니다. 세션, 스레드, 메모리 버전, 에이전트 버전 같은 리소스를 익혀야 하고, 비용이 스레드와 세션과 하니스의 고정 입력에 흩어져서 한 숫자로 보이지 않습니다. 실제로 멀티에이전트 세션은 스레드 비용의 합과 세션 비용이 2센트 어긋났습니다. 한 요청이 실제로 얼마를 썼는지는 사용량 객체와 스레드 통계를 함께 읽어야 합니다.
14. 따라 해 보려면
순서는 간단합니다. 저장소를 받고, generate_log.py로 로그를 만들고, 키를 .env에 넣고, agent.py의 빈 함수를 채우고, check.py로 부분마다 확인합니다. 네 부분을 모두 돌리면 환경 하나, 에이전트 둘, 스킬 둘, 메모리 스토어 둘, 업로드한 파일 하나, 세션 여러 개가 계정에 남습니다. 끝나면 python cleanup.py --dry-run으로 대상을 확인하고 python cleanup.py로 지웁니다. 이 정리는 세션, 파일, 스킬, 메모리 스토어, 환경을 지우고, 에이전트는 지울 수 없으므로 아카이브합니다.
비용 범위는 이 글의 실행 기준으로 적습니다. 기본 설정(지휘관과 조사관 모두 claude-opus-5-5)으로 부분 1은 20센트, 부분 2는 113센트, 부분 3은 116센트(메모리가 이미 있는 둘째 세션은 111센트), 부분 4의 조사와 PDF 두 턴은 149센트였습니다. 이 다섯 세션의 합이 약 $5.09입니다. README는 조사관을 claude-haiku-5-5로 바꾸면 더 빠르고 싸다고 적는데, 그 설정은 실행하지 않았습니다.
여러 사람이 키 하나를 나눠 쓰는 경우를 위해 저장소가 두 가지를 해 둡니다. 모든 리소스에 핸들을 붙여 이름이 겹치지 않게 하고, 정리 스크립트는 소유자 태그가 내 핸들인 리소스만 건드립니다. 공유 키는 어디까지나 공유 키이므로, 워크숍 전용 워크스페이스에서 지출 한도를 걸어 만든 키를 쓰고 끝난 뒤 지우라는 안내가 README에 있습니다. 이 저장소는 Apache-2.0이지만 유지보수되지 않는 워크숍 샘플입니다.
참고 자료
- Scaling Managed Agents: Decoupling the brain from the hands, Anthropic[1]
- Ship your first managed agent, Code with Claude London 워크숍 강연 (Anthropic Applied AI 팀)
- anthropics/cwc-workshops, ship-your-first-managed-agent, GitHub[2]
- Claude Managed Agents overview, Claude Platform Docs[3]
- Managed Agents files, Claude Platform Docs[4]
- 에이전트 런타임을 제공자가 맡기 시작했다: Managed Agents와 OpenAI Agents API, 2편
참고 링크 · 4
- [1] Scaling Managed Agents: Decoupling the brain from the hands, Anthropic — anthropic.com
- [2] anthropics/cwc-workshops, ship-your-first-managed-agent, GitHub — github.com
- [3] Claude Managed Agents overview, Claude Platform Docs — platform.claude.com
- [4] Managed Agents files, Claude Platform Docs — platform.claude.com