병목은 GPU가 아니라 그 뒤에 있었다
GPU가 그래프를 지은 뒤 CREATE INDEX에 남은 시간의 추적. GPU로 짓는 HNSW의 진단 빌드에서는 약 82초 가운데 약 49초가 그래프를 PostgreSQL 페이지로 옮기는 단계였고, CAGRA에서는 직접 빌드보다 약 15초가 더 걸렸습니다. 두 사례의 원인과 줄어든 정도(CAGRA는 아직 실험 빌드)를 측정 조건과 함께 정리했습니다.
앞 글에서는 pg_cuvs의 PGConf.Asia 2026 발표를 정리하면서 PostgreSQL을 거치는 비용을 두 문단으로 요약했습니다. 이 글에서는 그중 인덱스 빌드에 드는 비용을 자세히 다룹니다. 대상은 pg_cuvs의 인덱스 가운데 GPU로 그래프를 만드는 두 가지입니다. 하나는 GPU에서 그래프를 만들고 CPU에서 pgvector가 서빙하는 HNSW 인덱스(pg_cuvs_hnsw)이고, 다른 하나는 빌드와 검색을 모두 GPU가 맡는 CAGRA 인덱스입니다. 두 인덱스 모두 GPU에서 그래프를 만든 뒤에도 CREATE INDEX가 끝나기까지 상당한 시간이 더 걸렸습니다. 이 시간을 구간별로 나눠 측정해 원인을 찾았습니다.
먼저 결과를 측정 조건과 함께 적습니다.
- HNSW: 768차원 벡터 999,000개에서 진단 빌드의
CREATE INDEX는 약 82초가 걸렸고(1회 측정), 그중 약 49초는 GPU에서 만든 그래프를 PostgreSQL 인덱스 페이지로 옮기는 데 쓰였습니다. 원인은 약 8 MB짜리 표를 32 KB 캐시로 수천만 번 반복해서 읽는 것이었습니다. 이 문제를 포함해 해당 단계와 전후 구간을 줄인 네 변경(#210[1], #213[2], #214[3], #215[4])은 0.9.1에 릴리스했습니다. 네 변경을 모두 적용한 측정에서는 약 25.6초가 걸렸습니다(build_algo = 'ivf_pq',ef_construction = 128, 패치한 cuVS 26.04를 고정한 3회 중앙값). 다만 82초와 25.6초는 한 실험에서 나온 값이 아닙니다. - CAGRA: 768차원 벡터 100만 개로 같은 GPU 서버에서 인덱스를 빌드했을 때(
graph_degree64, intermediate 64, 3회 중앙값), cuVS를 직접 호출하면 약 12.1초, pg_cuvs v0.9.2의CREATE INDEX로는 약 27.2초가 걸렸습니다. PostgreSQL을 거치면서 약 15초, 직접 빌드 시간의 약 124%가 더해졌습니다. 같은 종류의 다른 서버에서 기본 설정으로 이 15초를 구간별로 나눠 측정한 결과, 대부분은 GPU 빌드가 끝난 뒤 데몬이 인덱스 파일을 저장하는 데 쓰인 시간이었습니다. 그중 절반 이상은 스레드 하나로 계산하는 체크섬에 쓰였습니다. 저장 경로를 수정한 실험 빌드는 같은 설정에서 약 16.6초가 걸렸고, 추가 시간은 약 4.4초(약 37%)로 줄었습니다. 이 실험 빌드는 아직 병합되지 않았으며 릴리스에도 포함되지 않았습니다.
모든 측정은 프로젝트 내부에서 수행했으며, 외부에서 독립적으로 재현되지는 않았습니다.
두 인덱스의 CREATE INDEX가 하는 일
pg_cuvs는 PostgreSQL 백엔드마다 로드되는 확장과 GPU를 가진 단일 데몬 프로세스(pg_cuvs_server)로 구성됩니다. 두 인덱스 모두 백엔드가 테이블을 읽어 데몬에 전달하고, 데몬은 GPU에서 그래프를 만듭니다. 이후의 작업은 서로 다릅니다.
CREATE INDEX ... USING pg_cuvs_hnsw의 기본 빌드에서는 데몬이 GPU에서 만든 그래프를 hnswlib 형식의 임시 파일에 씁니다. 백엔드는 이 파일을 읽어 pgvector의 HNSW 페이지 형식으로 변환한 뒤 PostgreSQL 인덱스에 씁니다(ARCHITECTURE.md 3.1b[5]). 이 마지막 단계를 반입이라고 부릅니다. 반입이 끝난 인덱스는 pgvector가 서빙하므로 검색할 때는 데몬이 필요하지 않습니다.
CREATE INDEX ... USING cagra에서는 데몬이 인덱스를 직접 파일로 저장합니다. 데몬은 인덱스 파일을 임시 이름으로 쓴 뒤 디스크에 동기화(fsync)하고, 이름을 바꾼 다음에야 응답합니다. CREATE INDEX가 성공으로 반환됐다면 파일이 디스크에 있다는 것이 이 명령의 약속입니다. cuVS를 직접 호출했을 때의 시간에는 이 약속이 포함되지 않습니다.
HNSW: 82초 가운데 49초가 반입
768차원 벡터 999,000개에서 진단 빌드의 CREATE INDEX는 약 82초가 걸렸고(1회 측정), 그중 약 49초가 반입에 쓰였습니다. 반입 코드는 노드마다 인덱스 내부의 위치를 표에서 찾았는데, 이 표를 네 페이지(32 KB)짜리 캐시로 반복해서 읽고 있었습니다. 접근 순서를 재생해 보니 위치 조회 64,935,002번 중 56,497,735번(87%)이 캐시 미스였습니다. 약 8 MB짜리 표를 읽기 위해 8 KB 읽기 요청을 약 462 GB어치 보낸 셈이었습니다.
위치가 규칙적으로 배치된다는 점을 이용해 위치를 읽는 대신 계산하도록 수정했습니다(#210[1]). 그 결과 반입은 48.57초에서 11.25초로, CREATE INDEX는 81.67초에서 44.27초로 줄었습니다(진단 빌드에서 1회씩, WAL 바이트는 같음). 계층이 있는 그래프에는 이 계산이 적용되지 않으므로 이득이 없습니다.
HNSW: 이어진 세 변경
이후 변경들은 구간별로 측정한 기준선에서 출발했습니다. 3회 중앙값으로 CREATE INDEX는 33.150초였으며, 구간별 시간은 다음과 같았습니다(#213[2]).
| 구간 | 시간 |
|---|---|
| 테이블 읽기와 데몬에 넘길 파일 쓰기, 사전 검사 | 8.967초 |
| 데몬 작업(GPU 그래프 빌드 포함) | 9.941초 |
| 데몬 응답 뒤의 반입 | 14.105초 |
이 표의 반입 시간(14.105초)은 #210 이후의 반입 시간(11.25초)과 측정 구간도 빌드도 달라 직접 비교하지 않습니다. 데몬 작업에 약 10초가 걸린 빌드에서 그 전후의 백엔드 구간에는 약 23초가 소요됐습니다. 이어진 세 변경은 모두 이 백엔드 구간을 줄였습니다.
- 페이지를 한 블록씩 늘리던 방식을 최대 32개씩 늘리도록 바꿨습니다(#213[2]).
CREATE INDEX는 33.150초에서 30.004초로, 반입은 14.105초에서 11.130초로 줄었습니다. - 입력 해시를 테이블을 읽으면서 행마다 계산하는 대신, 데몬의 응답을 기다리는 동안 계산하도록 옮겼습니다(#214[3]).
CREATE INDEX는 30.145초에서 28.145초로, 데몬 앞의 구간은 8.982초에서 6.882초로 줄었습니다. - 백엔드가 데몬이 쓴 파일을 필드마다 따로 읽던 방식을 1 MiB 창으로 읽도록 바꿨습니다(#215[4]). 백엔드의 읽기 호출은 9,991,134번에서 7,537번으로 줄었습니다.
CREATE INDEX는 이 변경만으로 30.145초에서 27.739초로 줄었고, #214와 함께 적용했을 때는 25.608초가 됐습니다.
모두 3회 중앙값이며, 데몬 작업 시간은 #213과 #214의 측정에서 9.9~10.0초로 그대로였습니다. 네 변경은 모두 0.9.1에 포함됐습니다.
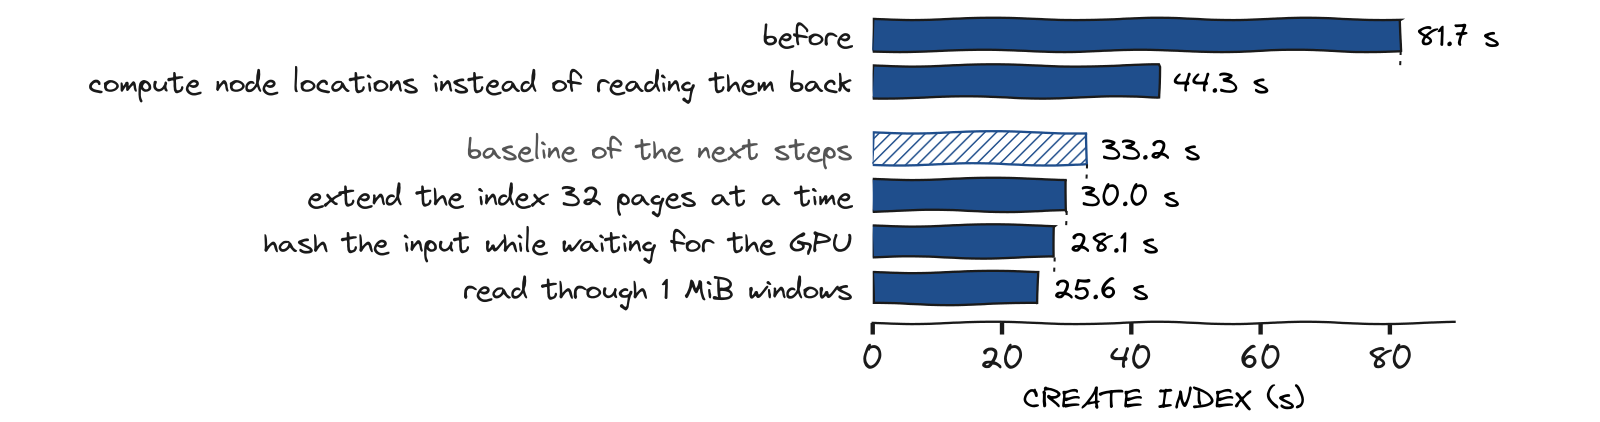
그림 1. CREATE INDEX ... USING pg_cuvs_hnsw의 변경별 시간. 999,000 x 768, A100-SXM4-80GB VM 한 대, build_algo = 'ivf_pq', ef_construction = 128. 첫 두 막대는 진단 빌드의 1회 측정, 나머지는 3회 중앙값입니다. 3회 중앙값은 패치한 cuVS 26.04를 고정해 잰 값이라 절대 시간은 그 SDK에서만 성립하고, 변경 사이의 차이만 pg_cuvs 코드에서 옵니다(CHANGELOG 0.9.1, PR #213~#215). 발표 슬라이드의 그림입니다.
다만 82초와 25.6초는 한 실험에서 나온 값이 아닙니다. 첫 두 막대는 진단 빌드의 1회 측정이며, 44.27초와 다음 기준선인 33.15초 사이의 차이는 변경 기록에 설명이 없습니다. #214와 #215는 #213의 결과(30.004초)가 아니라 같은 코드를 다시 측정한 30.145초를 기준으로 삼았습니다. 따라서 "네 변경으로 82초가 25.6초가 됐다"고 말하지 않고, 양 끝의 값과 각 변경에서 측정한 차이만 적습니다. 82초 중 GPU 작업에 쓰인 시간이 얼마였는지는 기록이 없습니다. 측정 조건과 각 변경의 대가는 CHANGELOG 0.9.1[6]과 각 PR에 있습니다.
CAGRA: 직접 빌드보다 15초
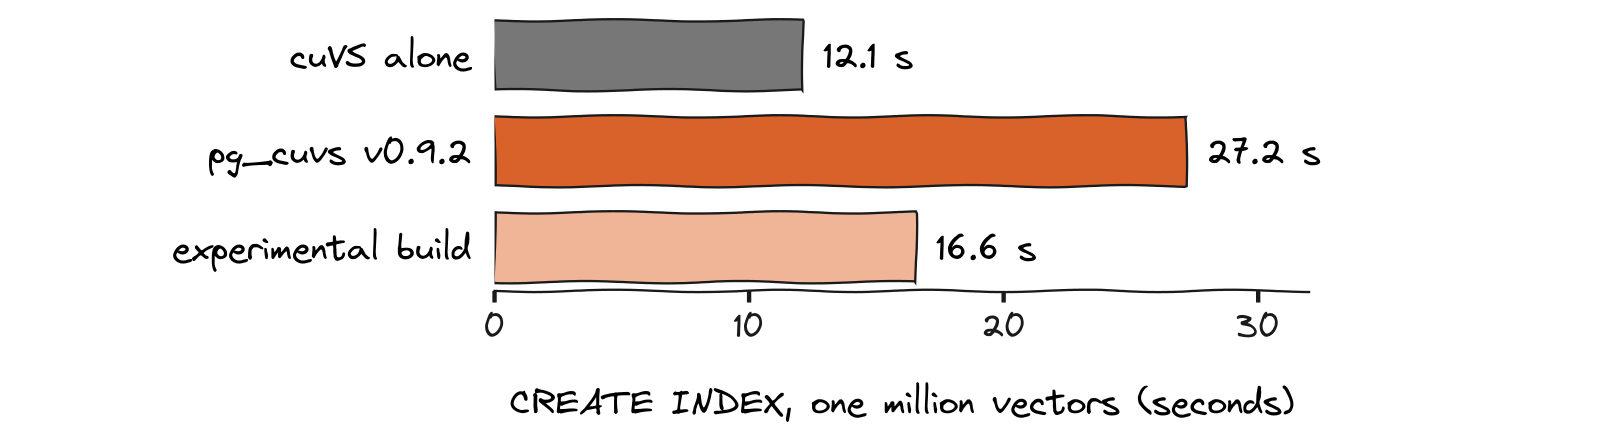
그림 2. 100만 x 768, CAGRA graph_degree 64, intermediate 64, 같은 GPU 서버(A100-SXM4-80GB)에서 3회 중앙값. 실험 빌드는 릴리스에 없습니다. 발표 슬라이드의 그림입니다.
그림 2의 세 값은 같은 서버에서 같은 날 측정했습니다. 다만 차이를 해석할 때는 몇 가지 조건을 함께 고려해야 합니다.
- 직접 빌드는 cuVS의 벤치마크 도구로 측정한 라이브러리 빌드 시간이고, pg_cuvs 쪽은 psql이 측정한
CREATE INDEX전체 시간입니다. 두 측정은 구간이 다릅니다. 따라서 15초는 "PostgreSQL을 거치며 더해진 시간"이지, 특정 단계 하나에 걸린 시간이 아닙니다. - 두 측정은 같은 날 같은 서버에서 수행했지만 같은 시각에 진행하지는 않았습니다. pg_cuvs를 측정할 때는 데몬이 실행 중이었고, 직접 빌드를 측정할 때는 데몬이 없었습니다.
- 데몬이 로그에 남기는 GPU 빌드 시간은 직접 빌드 시간보다 1~1.6초 짧게 나옵니다. 두 값이 정확히 같은 구간을 측정하는지는 확인하지 않았습니다. 따라서
CREATE INDEX시간에서 데몬의 GPU 빌드 시간을 뺀 값을 직접 빌드 대비 추가 시간과 같은 것으로 해석하지 않습니다.
설정을 바꿔도 추가 시간은 거의 같았습니다. 9개 설정에서 직접 호출과 PostgreSQL 경유를 한 번씩 짝지어 측정한 별도의 비교에서는 9개 빌드 모두 PostgreSQL 쪽이 14.96~15.86초 더 걸렸습니다(단일 실행, 두 쪽의 libcuvs 빌드가 다름). 설정이 달라져도 추가 시간은 약 15초로 거의 일정했습니다.
CAGRA: 15초는 어디로 갔나
이 15초를 같은 종류의 다른 A100 서버에서 기본 설정(graph_degree 64, intermediate 128)으로 구간별로 측정했습니다(#233[7]). 그림 2와는 서버와 설정이 모두 다르므로 한 실험으로 읽지 않습니다. 이 서버에서 CREATE INDEX는 27.53~27.83초(5회)가 걸렸으며, 그중 GPU 빌드에는 12.00~12.23초, 빌드 이후 저장 단계에는 15.01~15.21초가 소요됐습니다. 같은 종류의 서버에서 별도로 측정한 분해 결과, 테이블을 읽어 데몬에 넘기는 데는 약 0.2초가 걸렸습니다.
저장 작업은 데몬의 스레드 하나가 순차적으로 수행합니다. 계측 로그만 추가해 3회 측정한 분해 결과는 다음과 같습니다.
| 저장 단계의 일 | 시간 |
|---|---|
벡터 파일(.vectors) 본문의 CRC32 계산 | 8.27초 |
.vectors 쓰기 | 1.58초 |
.vectors fsync | 0.73~0.81초 |
CAGRA 인덱스 직렬화(.cagra, 벡터를 다시 포함) | 3.45~3.47초 |
.cagra fsync | 0.73~0.86초 |
| 나머지(행 주소 파일, 이름 바꾸기, 등록) | 약 0.12초 |
저장 단계의 절반 이상은 약 3 GB의 벡터(100만 x 768 x 4바이트)에 바이트 단위로 체크섬을 계산하는 데 쓰였습니다. 이 동안 데몬에서 CPU를 사용한 것은 스레드 하나뿐이었고, 나머지 23개 vCPU는 쉬고 있었습니다. 디스크 쓰기 속도는 평균 360~382 MB/s로, 같은 디스크에서 dd로 측정한 한계(버퍼 쓰기와 fsync 기준 약 0.9 GB/s)에 도달하지 않았습니다. 병목은 디스크가 아니라 스레드 하나에 있었습니다.
이 가운데 두 번의 fsync(합계 약 1.5초)는 앞서 설명한 CREATE INDEX의 약속을 지키는 데 드는 비용입니다. 나머지 대부분은 저희 코드에서 발생했습니다.
같은 저장 단계에는 시간 외에 다른 비용도 있었습니다. 데몬은 저장하는 동안 전역 잠금(g_index_mutex)을 쥐고 있으므로 같은 데몬의 다른 인덱스 검색이 그동안 멈춥니다. 100만 벡터 빌드를 2회 수행하는 동안 별도 인덱스에 보낸 단건 질의 하나가 각각 15.21초, 15.14초 걸렸습니다. 같은 디스크에 6.1 GB를 쓰기만 한 대조 구간에서는 최대 지연이 14.6 ms였습니다. 이 문제는 이슈 #233에 열려 있습니다.
CAGRA: 저장 경로를 고친 실험 빌드
원인이 저장 단계에 있었으므로 저장 경로를 수정한 실험 빌드를 만들어 같은 서버에서 측정했습니다. 그림 2의 설정에서 CREATE INDEX는 약 16.6초가 걸렸으며, 직접 빌드(약 12.1초)보다 약 4.4초, 직접 빌드 시간의 약 37% 더 걸렸습니다. v0.9.2에서는 약 124%였던 추가 시간이 이렇게 줄었습니다. 9개 설정 모두에서 실험 빌드는 v0.9.2보다 9.9~10.8초 짧았으며, 단일 질의 검색은 릴리스와 몇 % 안의 차이였습니다.
이 결과는 신중하게 해석해야 합니다. 실험 빌드는 병합되지 않았으며 릴리스에도 포함되지 않았습니다. 실험 빌드의 변경 내용은 공개하지 않았고, 줄어든 시간을 변경별로 나눠 측정하지도 않았습니다. 위의 퍼센트는 그림 2의 설정 하나에서 공개한 세 값으로 계산한 것입니다.
두 사례에서 본 것
두 인덱스 모두 시간이 많이 든 곳은 GPU 작업이 아니라, GPU의 결과를 PostgreSQL 페이지나 디스크 파일로 옮기는 단계였습니다. HNSW에서는 8 MB짜리 표를 작은 캐시로 수천만 번 반복해서 읽었고, CAGRA에서는 스레드 하나가 3 GB에 체크섬을 계산했습니다. 두 원인은 모두 시간을 구간별로 나눠 측정한 뒤 확인됐습니다. HNSW는 반입 단계의 접근 순서를 재생해 측정했고, CAGRA는 저장 단계의 작업마다 로그를 추가해 측정했습니다.
다만 두 사례의 현재 상태는 다릅니다. HNSW의 네 변경은 0.9.1에 릴리스됐지만, CAGRA의 저장 경로 수정은 아직 실험 빌드에만 적용돼 있습니다.
남은 것
- 계층이 있는 HNSW 그래프에는 #210의 계산을 적용할 수 없습니다. #213은 assertion 빌드와 크래시 복구로 검증하지 않았고, #214는 데몬 빌드 이후 spool 재읽기에 실패하면 GPU 빌드 시간을 잃는 대가가 남았습니다.
- CAGRA 저장 경로를 수정한 실험 빌드는 릴리스에 포함되지 않았습니다. 저장 단계 동안 다른 검색이 멈추는 문제(#233)도 열려 있습니다.
- 실험 빌드에서도 직접 빌드보다 약 4.4초가 더 걸립니다. 이 4.4초는 구간별로 나눠 측정하지 않았습니다.
- 검색 쪽 비용, 즉 같은 설정 315쌍에서 PostgreSQL과 데몬을 거치며 질의당 추가된 0.25~0.32 ms는 아직 구간별로 나눠 측정하지 않았습니다.
모든 수치는 A100 한 종류와 100만 개 안팎의 768차원 벡터를 대상으로 프로젝트에서 직접 측정한 값입니다. 다른 GPU나 데이터 크기에서는 구간별 비중이 달라질 수 있습니다. HNSW 반입의 측정 결과는 CHANGELOG 0.9.1[6]과 각 PR에, CAGRA 저장 단계의 측정 결과는 이슈 #233[7]에 있습니다.
참고 링크 · 7
- [1] #210 — github.com
- [2] #213 — github.com
- [3] #214 — github.com
- [4] #215 — github.com
- [5] ARCHITECTURE.md 3.1b — github.com
- [6] CHANGELOG 0.9.1 — github.com
- [7] #233 — github.com